अपने 300 मिलियन-पैरामीटर LLM को क्वांटाइज़ करके CPU पर गति और सटीकता की तुलना की
पिछले लेख में बनाया गया क्रोएशियाई RAG के लिए 320 मिलियन-पैरामीटर मॉडल। इसे CPU पर चलाना है, इसलिए इस बार इसे क्वांटाइज़ करके देखा कि कितना छोटा और तेज़ बनाया जा सकता है, और सटीकता कितनी घटती है।
पहले निष्कर्ष।
- Q6_K बिल्कुल सही संतुलन है। आकार 1/5 (254MB), जनरेशन लगभग 4 गुना तेज़, और सटीकता मूल मॉडल जितनी ही
- Q2_K टूट जाता है। तेज़ है, लेकिन जिन सवालों का जवाब मौजूद है उनमें भी कहने लगता है कि “कोई जवाब नहीं है”
- हैरानी की बात है कि Q3_K_M, Q4_K_M से अधिक सटीक निकला
क्या किया
PyTorch में बने मॉडल को CPU अनुमान के लिए अक्सर इस्तेमाल होने वाले llama.cpp में चलने योग्य प्रारूप (GGUF) में बदला और 8 अलग-अलग सटीकताओं में सहेजा।
- मॉडल को Qwen3 के समान प्रारूप में एक्सपोर्ट करके GGUF में बदला
- टोकनाइज़र अपना बनाया हुआ था, इसलिए llama.cpp ने इसे “अज्ञात टोकनाइज़र” मानकर रूपांतरण से इनकार कर दिया। शब्द विभाजन के नियमों की तुलना की तो वे Qwen2 से अक्षरशः समान थे, इसलिए इसे Qwen2 के रूप में पंजीकृत करके रूपांतरण कराया
- जाँचा कि रूपांतरण सही है या नहीं। 160 वाक्यों का टोकन विभाजन PyTorch संस्करण से पूरी तरह मिला। 20 सवालों में हर बार सबसे अधिक संभावना वाला शब्द चुनकर जनरेशन कराई, तो सभी 20 आउटपुट भी पूरी तरह समान थे
llama-quantizeसे F16 से Q2_K तक बनाए
इसलिए तालिका का F32, PyTorch संस्करण के समान ही मॉडल है। यही तुलना का आधार है।
मापने का तरीका
- CPU i7-13700K है। GPU इस्तेमाल नहीं किया गया
- llama.cpp की सेटिंग: जनरेशन के लिए 8 थ्रेड, पाठ लोड करने के लिए 16 थ्रेड (परीक्षण में यही सबसे तेज़ रहा)
- मूल्यांकन के लिए 100 सवाल × 4 तरह के संदर्भों में, हर मॉडल से 400 बार जवाब लिया
- अनुच्छेद: उत्तर वाला लगभग 100 टोकन का अनुच्छेद
- लंबा पाठ: उत्तर वाला लगभग 3,000 टोकन का लेख (इसमें असंबंधित लेख भी मिलाए गए हैं)
- कोई उत्तर नहीं (अनुच्छेद/लंबा पाठ): ऐसा पाठ जिसमें उत्तर नहीं है। मना कर दे तो सही माना गया
- पिछले लेख में 300 सवालों पर मापा था, इसलिए आंकड़ों में थोड़ा अंतर है
परिणाम: सटीकता
| प्रारूप | आकार | अनुच्छेद सही | लंबे पाठ में सही | लंबे पाठ में मना किया | गढ़ा हुआ उत्तर (बिना उत्तर वाले अनुच्छेद/लंबे पाठ) | सत्यापन के बाद सटीकता |
|---|---|---|---|---|---|---|
| F32(आधार) | 1,233MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81.9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81.3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84.4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75.9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80.4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72.2% |
“सत्यापन के बाद सटीकता” में प्रोग्राम से जाँचा गया कि मॉडल का उद्धरण सचमुच पाठ में मौजूद है या नहीं। अगर नहीं मिला, तो उसे “कोई उत्तर नहीं” से बदलने के बाद दिए गए उत्तरों में सही उत्तरों का अनुपात निकाला गया।
- F16, Q8_0 और Q6_K आधार के लगभग समान हैं। अंतर केवल 1–2 सवालों का है
- Q5_K_M से नीचे, गलतियों से अधिक “मना करने” की संख्या बढ़ती है। ऐसा लगता है कि आत्मविश्वास कम होने पर मॉडल मना कर देता है—पिछली बार सिखाया गया यह व्यवहार वैसा ही दिख रहा है। गढ़े हुए उत्तर नहीं बढ़े हैं
- Q4_K_M, Q3_K_M से खराब है। लंबे पाठ में 37% बनाम 48%। 100 सवालों में कुछ उतार-चढ़ाव हो सकता है, लेकिन 11 अंक का अंतर बड़ा है। कारण अभी नहीं जाँचा गया है
- Q2_K लंबे पाठ के 78% सवालों से मना करता है। यह अब एक अलग ही मॉडल है
परिणाम: गति
| प्रारूप | जनरेशन गति | एक बार का औसत समय |
|---|---|---|
| PyTorch fp32(संदर्भ) | अनुच्छेद 14.6・लंबा पाठ 6.7 tok/s | — |
| F32 | 18.7 tok/s | 2.76 सेकंड |
| F16 | 35.9 tok/s | 2.08 सेकंड |
| Q8_0 | 59.0 tok/s | 1.93 सेकंड |
| Q6_K | 73.1 tok/s | 1.33 सेकंड |
| Q5_K_M | 81.2 tok/s | 1.26 सेकंड |
| Q4_K_M | 89.1 tok/s | 1.10 सेकंड |
| Q3_K_M | 103.4 tok/s | 1.12 सेकंड |
| Q2_K | 119.9 tok/s | 1.07 सेकंड |
llama.cpp के आंकड़े 400 रन का औसत हैं (अनुच्छेद, लंबा पाठ और बिना उत्तर वाले मामलों को मिलाकर)। PyTorch के आंकड़े पिछले लेख में मापे गए थे।
- जनरेशन की गति लगभग आकार के व्युत्क्रमानुपाती है। CPU पर गति गणना से अधिक मेमोरी से वज़न पढ़ने की गति पर निर्भर करती है, इसलिए मॉडल जितना छोटा होगा उतना तेज़ होगा
- एक ही F32 में भी llama.cpp, PyTorch से तेज़ है
- लेकिन Q6_K के नीचे, एक रन का समय बहुत कम नहीं होता। इस लंबाई पर शुरू में पाठ लोड करने का समय अधिक महत्वपूर्ण हो जाता है
वीडियो: CPU पर एक ही लंबे पाठ वाले सवाल को हल कराकर देखा
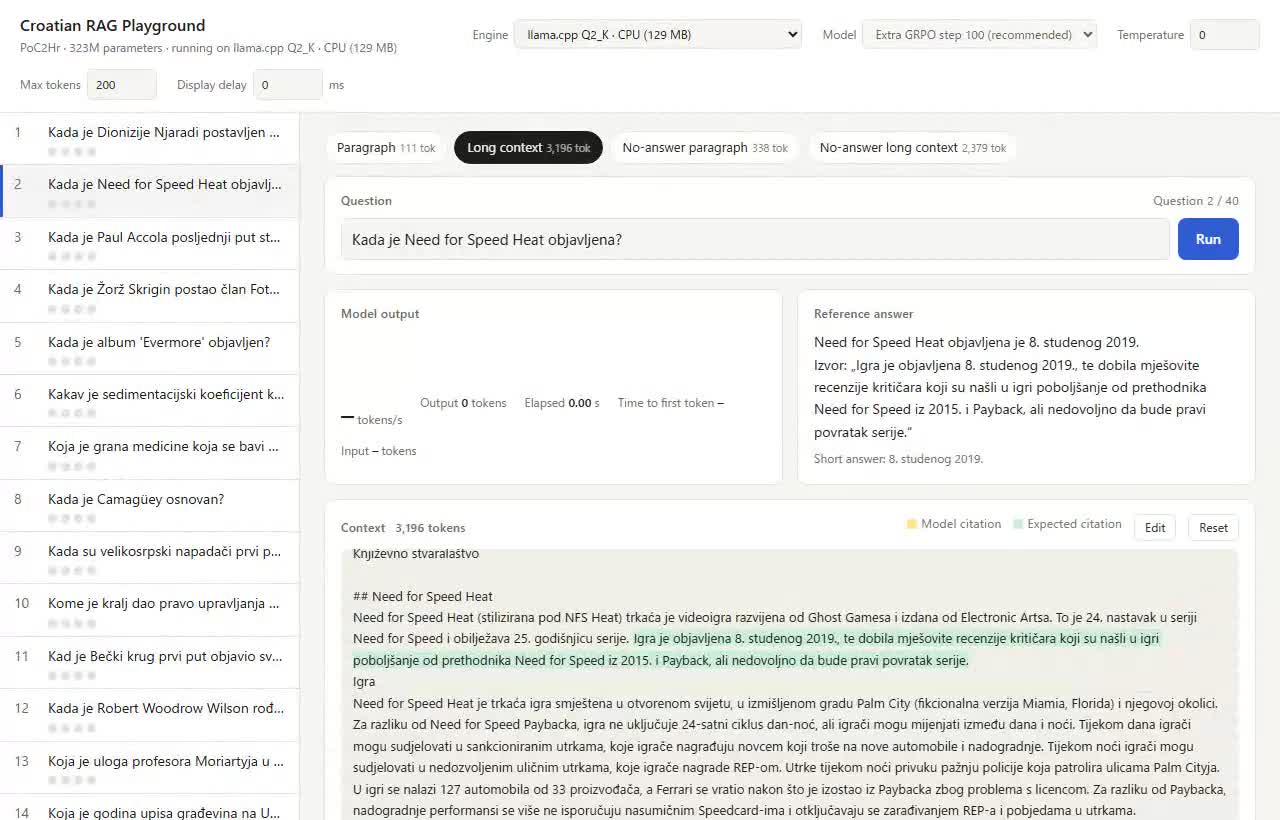
लगभग 3,200 टोकन का पाठ देकर पूछा: “Need for Speed Heat कब रिलीज़ हुआ था?” सही उत्तर 8 नवंबर 2019 है।
रिकॉर्डिंग करते हुए और ब्राउज़र में स्क्रीन रेंडर करते हुए चलाया गया है, इसलिए वीडियो में गति ऊपर की तालिका से धीमी है। इसे साथ-साथ तुलना के लिए देखें।
| प्रारूप | वीडियो में जनरेशन गति | पहला अक्षर आने तक | कुल | परिणाम |
|---|---|---|---|---|
| PyTorch fp32 | 5.5 tok/s | 4.8 सेकंड | 18.5 सेकंड | सही |
| F32 | 14.2 tok/s | 2.8 सेकंड | 8.1 सेकंड | सही |
| F16 | 25.9 tok/s | 3.5 सेकंड | 6.4 सेकंड | सही |
| Q8_0 | 38.2 tok/s | 4.0 सेकंड | 5.9 सेकंड | सही |
| Q6_K | 41.6 tok/s | 2.6 सेकंड | 4.4 सेकंड | सही |
| Q5_K_M | 46.3 tok/s | 2.6 सेकंड | 4.3 सेकंड | सही |
| Q4_K_M | 47.2 tok/s | 2.3 सेकंड | 4.7 सेकंड | सही(उत्तर थोड़ा लंबा) |
| Q3_K_M | 56.7 tok/s | 2.5 सेकंड | 4.5 सेकंड | सही(उत्तर थोड़ा लंबा) |
| Q2_K | 61.3 tok/s | 2.7 सेकंड | 2.8 सेकंड | मना किया |
F32 से Q5_K_M तक, उत्तर और उद्धरण दोनों PyTorch संस्करण से अक्षरशः समान थे। Q4_K_M और Q3_K_M में उत्तर का वाक्य लंबा हो गया, लेकिन उद्धरण सही था। Q2_K ने उत्तर मौजूद होने के बावजूद यह कहकर मना कर दिया कि “मुख्य पाठ में उत्तर नहीं है।”
PyTorch fp32(मूल मॉडल)
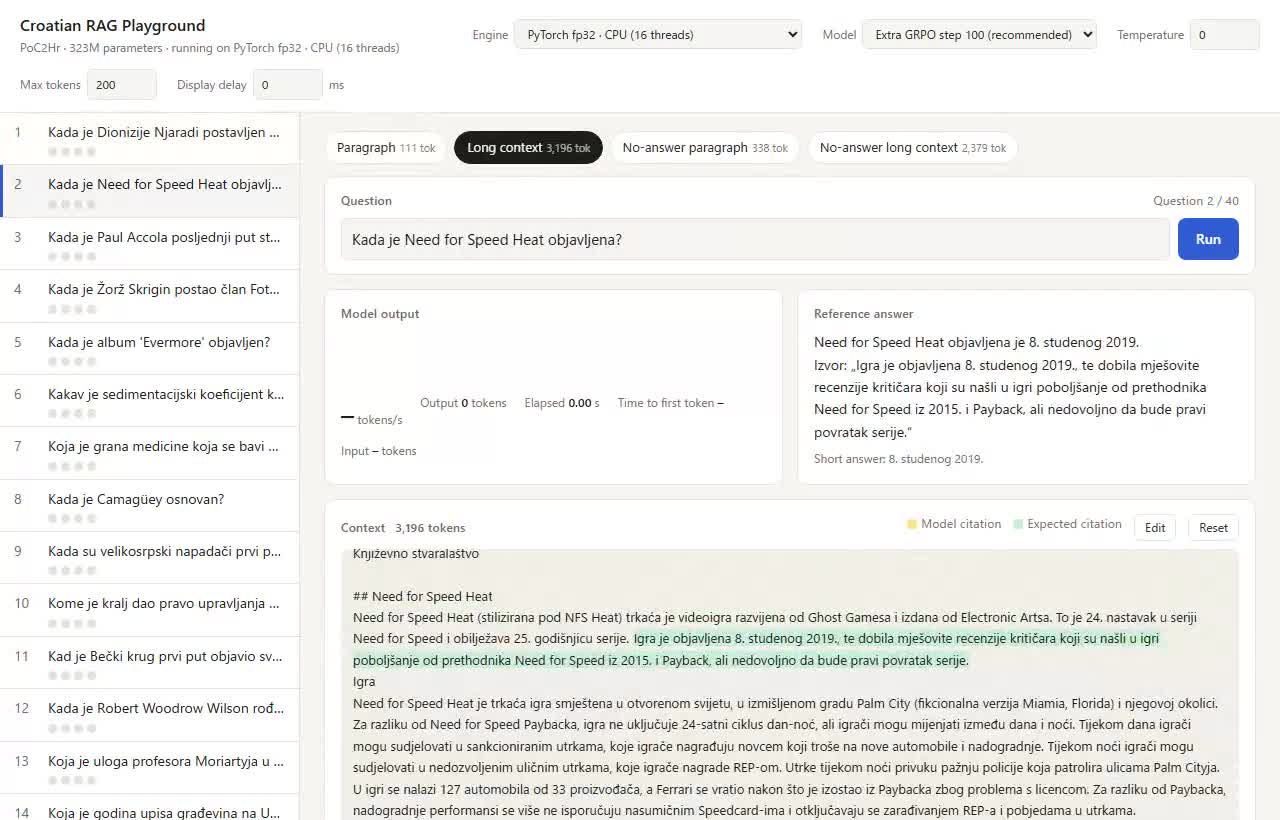
llama.cpp F32(1,233MB)
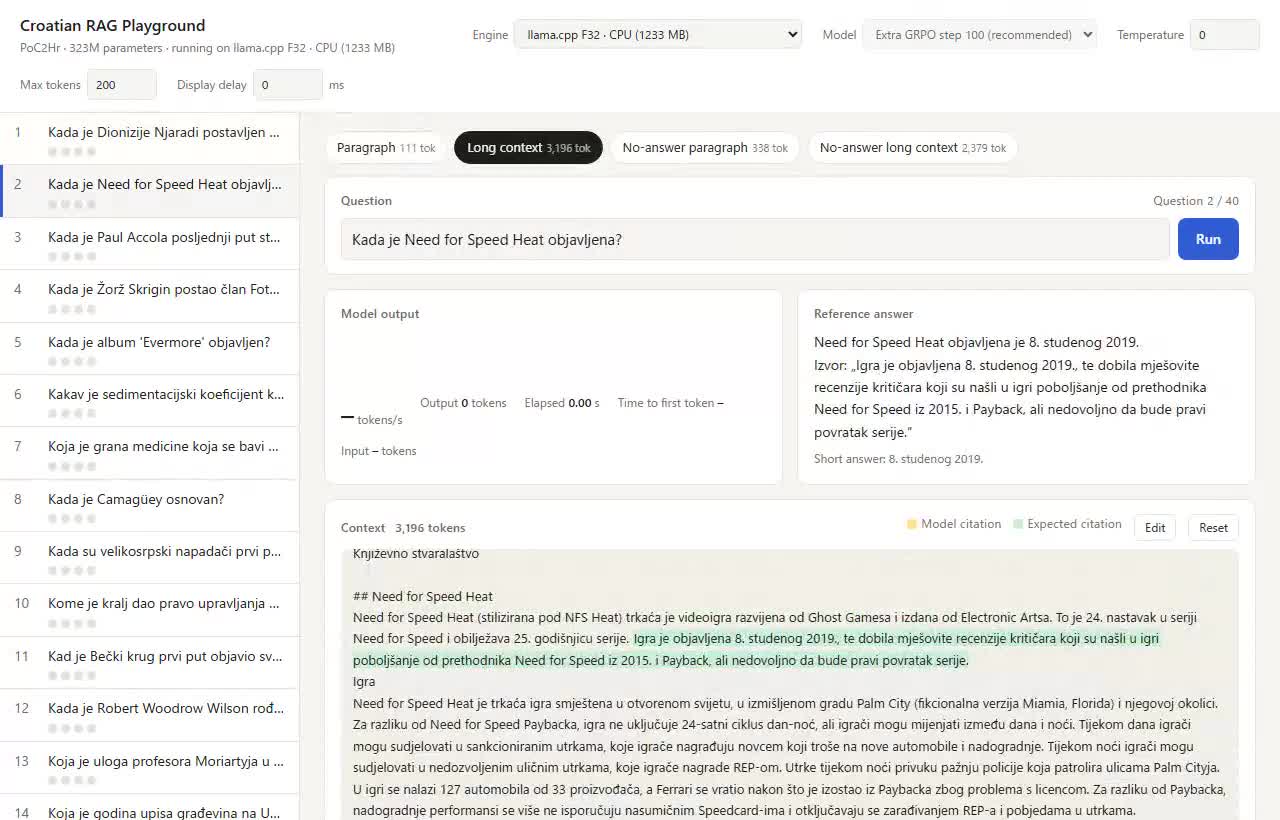
llama.cpp F16(617MB)
llama.cpp Q8_0(329MB)
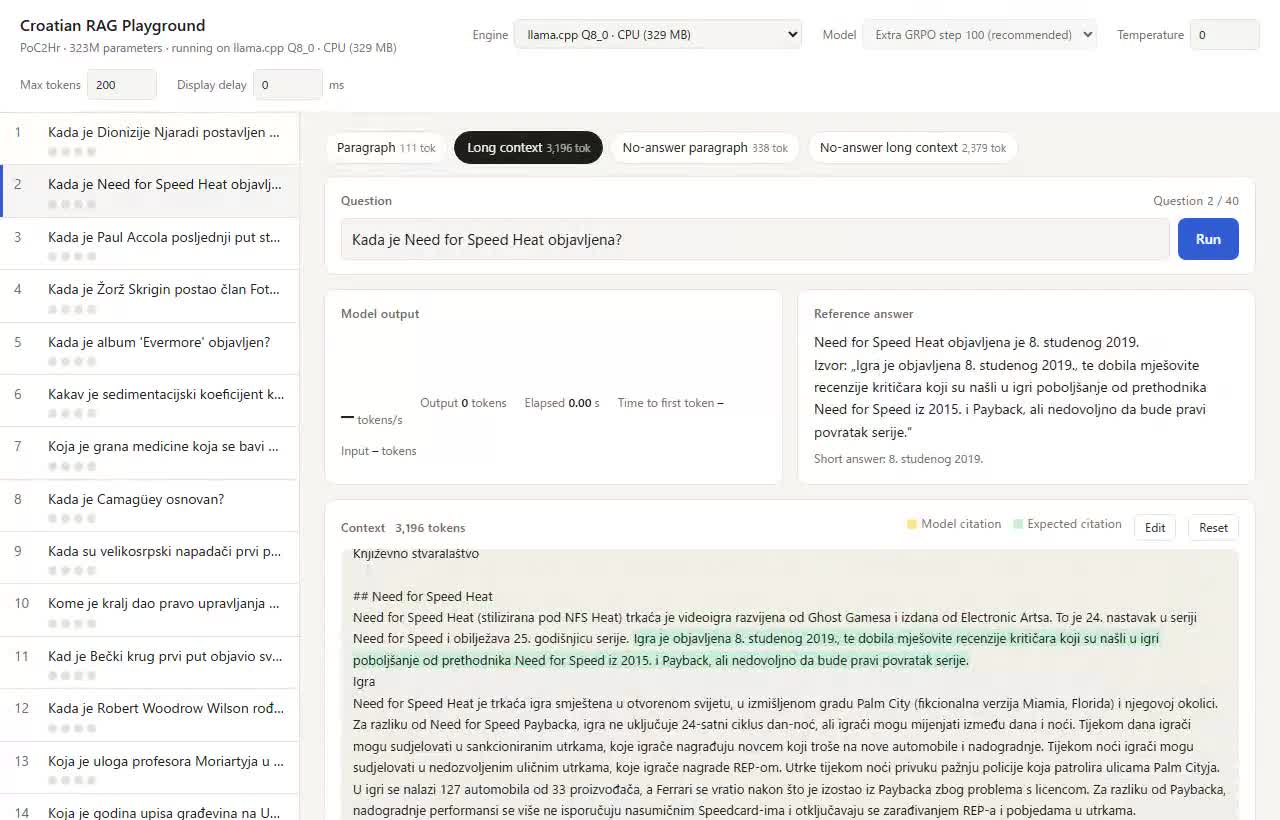
llama.cpp Q6_K(254MB)
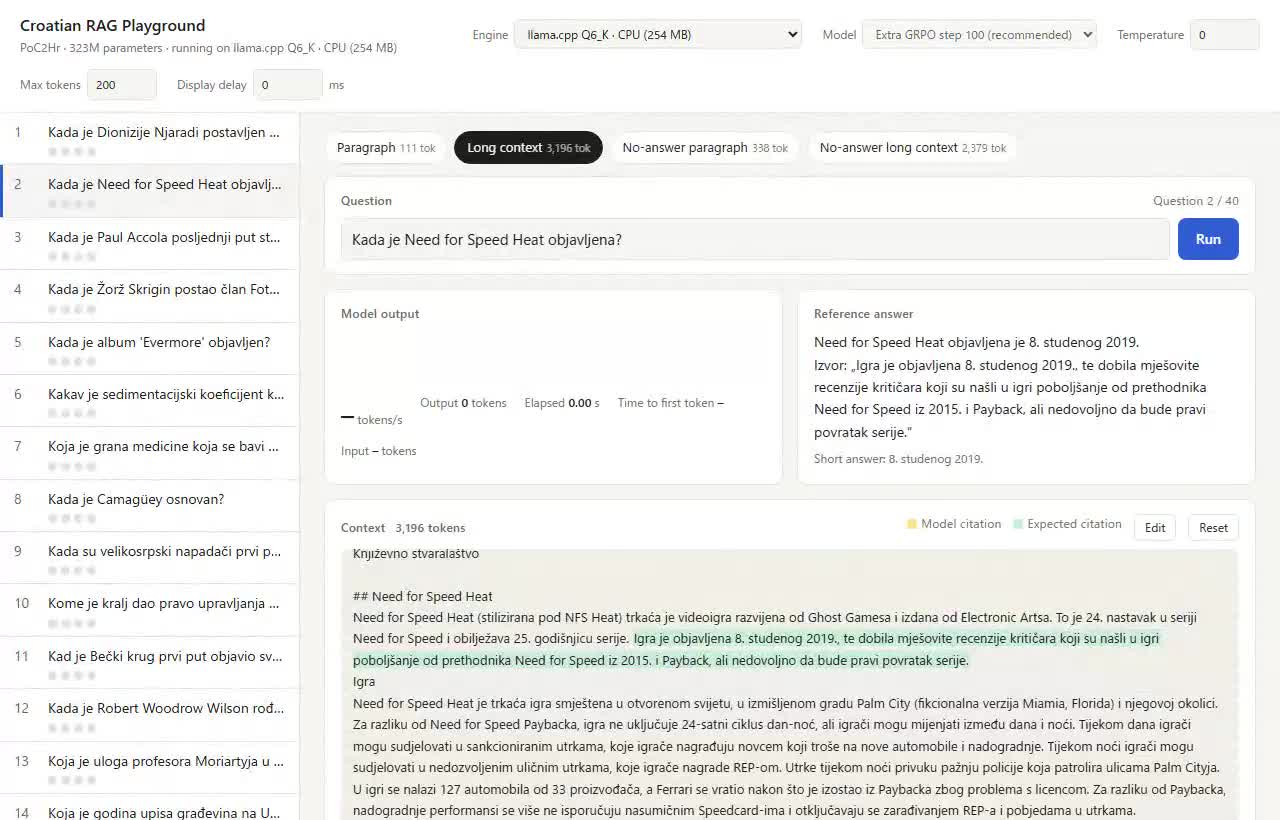
llama.cpp Q5_K_M(223MB)
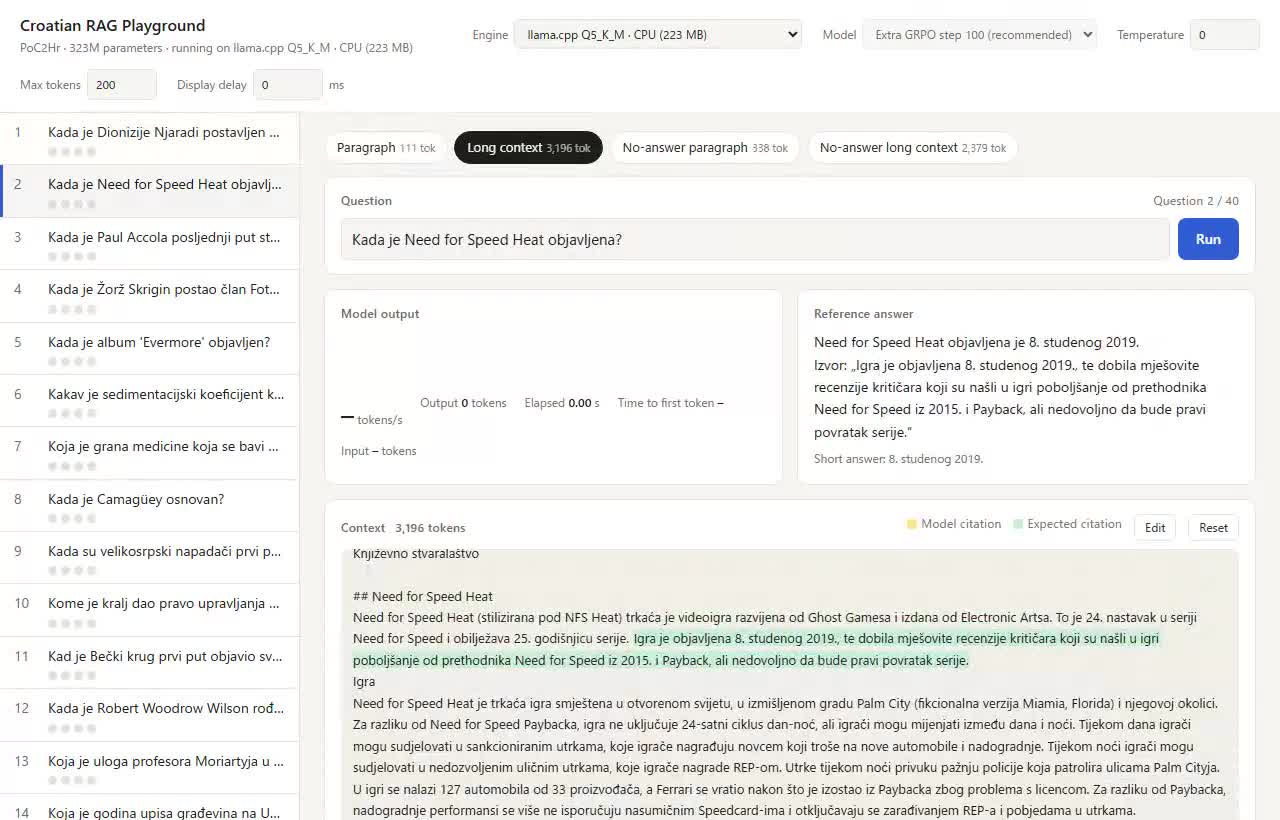
llama.cpp Q4_K_M(193MB)
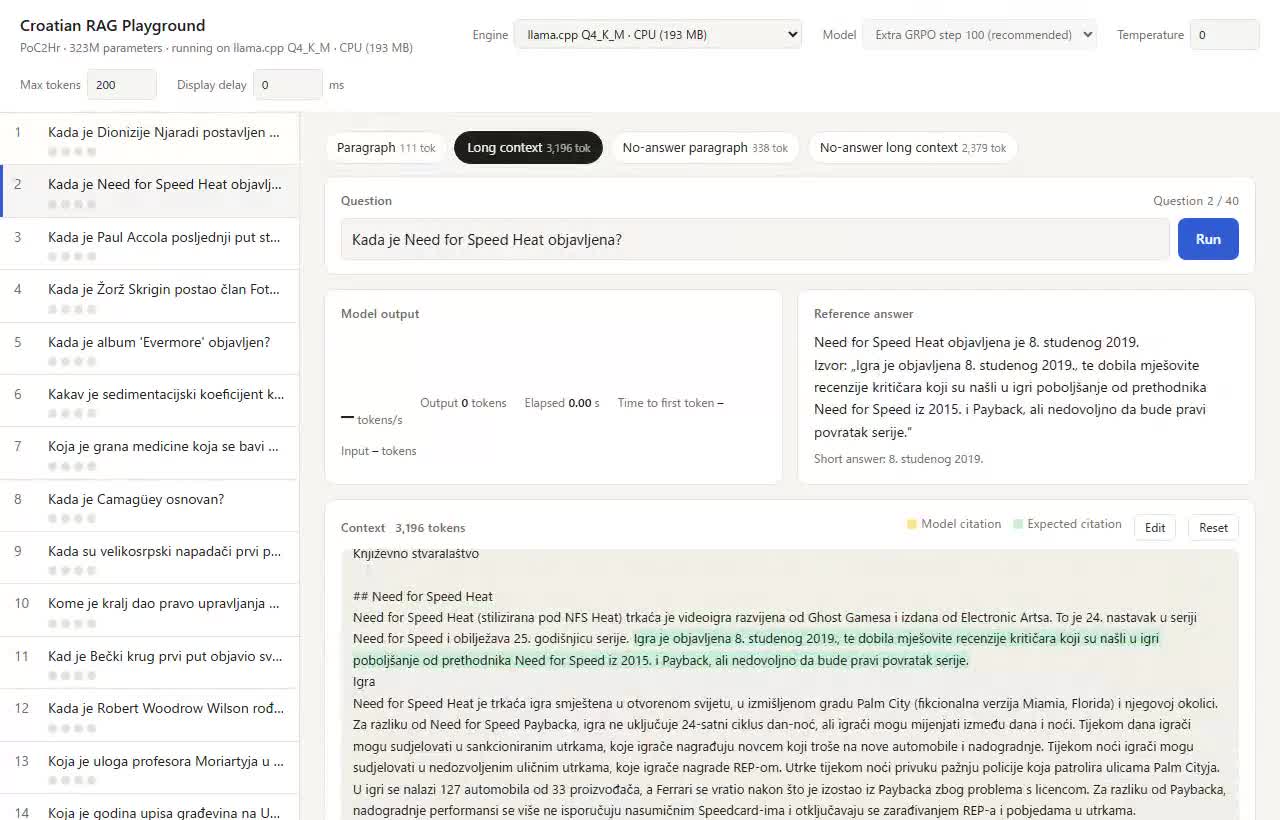
llama.cpp Q3_K_M(160MB)
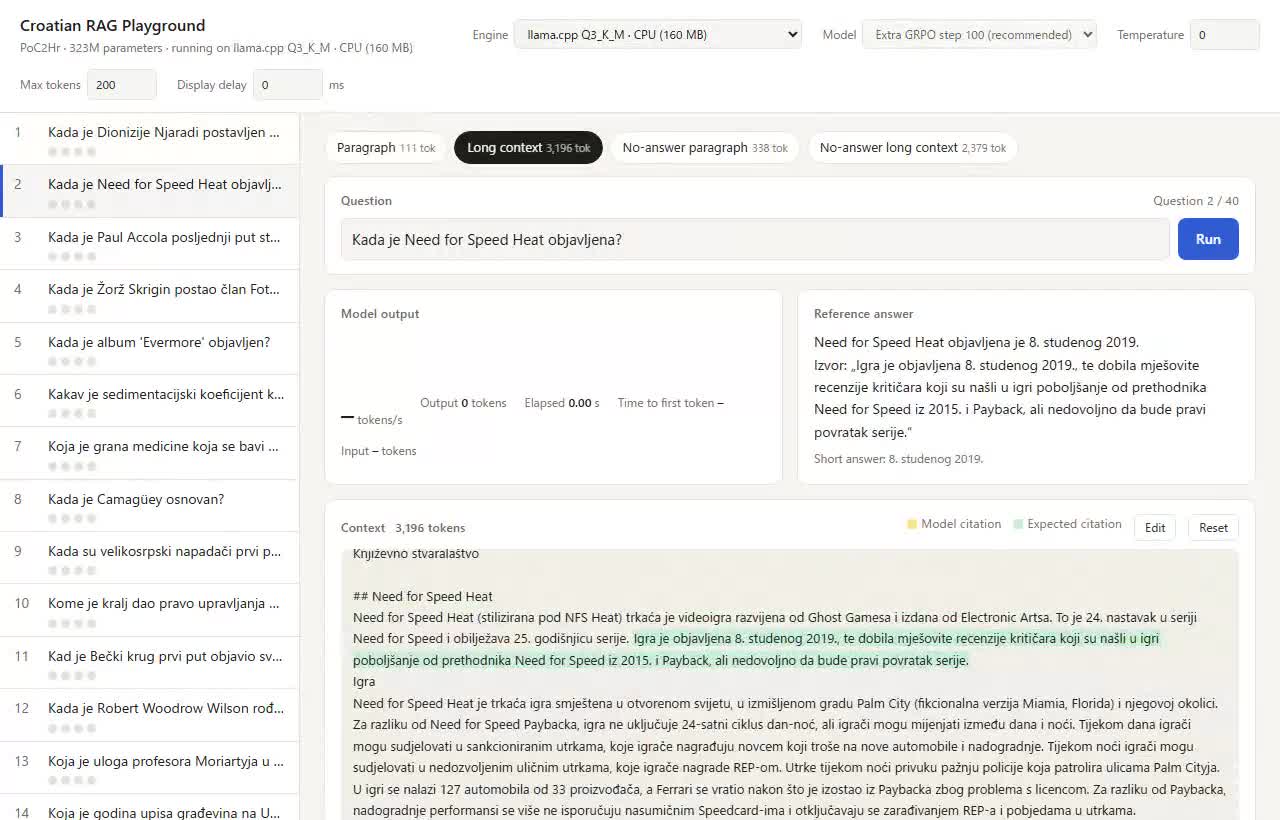
llama.cpp Q2_K(129MB)
विचार
- इस मॉडल को CPU पर चलाना हो तो Q6_K चुनें। सटीकता मूल मॉडल जैसी, आकार 1/5, और जनरेशन PyTorch से लगभग 5 गुना तेज़। संदेह की कोई वजह नहीं
- निश्चिंतता चाहिए तो Q8_0। यह मूल के लगभग समान है और केवल 329MB का है। फिर भी काफी छोटा है
- 300 मिलियन-पैरामीटर जैसे छोटे मॉडल क्वांटाइज़ेशन के प्रति संवेदनशील होते हैं। बड़े मॉडल के लिए कहा जाता है कि Q4 पर भी लगभग कोई गिरावट नहीं होती, लेकिन यहाँ Q5 से साफ़ गिरावट दिखी। मॉडल में पहले से ही कम गुंजाइश थी, इसलिए कटौती का असर पड़ता है
- टूटने का तरीका “मना करना” होना अच्छी बात है। RAG में गढ़े हुए उत्तर बढ़ने के बजाय मना करना अधिक सुरक्षित है। पिछली बार रिइनफोर्समेंट लर्निंग से मना करना सिखाने का प्रभाव यहाँ भी दिख रहा है
- छोटे मॉडल में गति का अंतर कम हो जाता है। Q6_K के नीचे जनरेशन तेज़ होने पर भी पाठ लोड करने का समय बचता है, इसलिए अनुभव में अधिक फर्क नहीं पड़ता। वीडियो में भी Q6_K से Q3_K_M तक लगभग 4 सेकंड के आसपास रहे
- Q4_K_M के Q3_K_M से हारने का कारण अभी स्पष्ट नहीं है। सवालों की संख्या बढ़ाकर या यह देखकर कि किस लेयर को कैसे क्वांटाइज़ किया जा रहा है, इसे और जाँचना चाहता हूँ