SLM की RAG क्षमता परखी: क्रोएशियाई और अंग्रेज़ी में 1B से 9B तक के 25 मॉडलों की तुलना
मेरे बनाए क्रोएशियाई RAG मॉडल को बनाकर क्वांटाइज़ भी कर लिया था, तो इस बार मैंने देखा कि दुनिया के छोटे मॉडल (SLM) RAG में कितने उपयोगी हैं। मैंने 1B वर्ग के 10, 3B वर्ग के 8 और 7B वर्ग के 7—कुल 25 मॉडलों के साथ अपना 320M मॉडल जोड़कर, उनसे क्रोएशियाई और अंग्रेज़ी में एक ही तरह के सवाल हल कराए।
अपडेट (उसी दिन): मैंने RAG के लिए खास तौर पर बनाए गए तीन छोटे मॉडल (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M) भी आज़माए। नतीजे लेख के दूसरे हिस्से, 「अपडेट: RAG-विशेष मॉडलों को भी आज़माया」 में हैं।
पहले निष्कर्ष।
- 3–4B वर्ग अब लगभग 8–9B वर्ग के बराबर है। क्रोएशियाई में कुल सटीकता Qwen3.5 4B और Gemma 4 E4B की 90% थी, जबकि सबसे ऊपर Qwen3.5 9B 91% पर था
- फर्क इस बात से पड़ता है कि मॉडल उत्तर न होने पर मना कर सकता है या नहीं। सटीकता में शीर्ष मॉडल Phi-4-mini ने उत्तर-विहीन लंबे पाठों के 64% मामलों में उत्तर गढ़ दिए
- अंग्रेज़ी में ऐसे मॉडल ज़्यादा हैं जो उत्तर मौजूद होने पर भी मना कर देते हैं। OLMo 3 7B ने अंग्रेज़ी अनुच्छेदों के 47% और MiniCPM5 2B ने 70% को मना कर दिया
- CPU पर 7B वर्ग को एक लंबे पाठ के सवाल में 30 सेकंड से अधिक लगते हैं। 1B वर्ग को 4–13 सेकंड लगे। मेरा 320M मॉडल 2.1 सेकंड में चला और उसकी सटीकता Qwen3.5 0.8B के लगभग बराबर थी
मैंने क्या किया
सवाल: पिछले लेख की तरह, क्रोएशियाई Wikipedia से बनाए गए प्रश्न। हर प्रश्न के लिए चार तरह के पाठ दिए गए।
- अनुच्छेद: लगभग 100 टोकन का वह अनुच्छेद जिसमें उत्तर है
- लंबा पाठ: लगभग 3,000 टोकन का वह पाठ जिसमें उत्तर है (इसमें असंबंधित लेख भी मिले हुए हैं)
- उत्तर नहीं (अनुच्छेद / लंबा पाठ): ऐसा पाठ जिसमें उत्तर नहीं है। अगर मॉडल 「पाठ में उत्तर नहीं है」 कहकर मना करे तो सही माना गया
अंग्रेज़ी संस्करण: उन्हीं प्रश्नों का EuroLLM-9B से अंग्रेज़ी अनुवाद किया। जिन प्रश्नों में अनुवाद के दौरान उत्तर गायब हो गया या अनुवाद किए बिना क्रोएशियाई में ही रह गया, उन्हें दोनों भाषाओं से हटा दिया गया; तुलना उन्हीं 260 प्रश्नों पर की गई।
निर्देश: हर भाषा में यह निर्देश दिया: 「नीचे दिए गए पाठ का ही उपयोग करके, एक वाक्य में संक्षेप में उत्तर दो। यदि उत्तर न हो तो केवल ‘पाठ में उत्तर नहीं है’ कहो।」
स्कोरिंग: Qwen3.5 9B से आदर्श उत्तर के साथ तुलना करवाकर 「सही, गलत, मना किया」 का निर्णय कराया। मैंने स्वयं 65 मामलों की जाँच की। यह स्कोरिंग थोड़ी उदार थी—मिसाल के लिए, केवल वर्ष बताने जैसे आंशिक उत्तर को भी सही मानती थी—लेकिन मना किया या नहीं, इसका निर्णय हर मामले में सही था।
कुल सटीकता: अनुच्छेद और लंबे पाठ में सही उत्तरों की संख्या तथा उत्तर न होने पर सही ढंग से मना करने की संख्या को जोड़कर, सभी प्रश्नों से भाग दिया गया। यह सही उत्तर देने और न जानने पर चुप रहने—दोनों को मापने वाला अंक है।
चलाने का तरीका: सटीकता को RTX 4090 पर vLLM से मापा गया, जिसमें हर बार सबसे अधिक संभाव्यता वाला शब्द चुना गया। जिन मॉडलों में सोचकर उत्तर देने वाला 「थिंकिंग मोड」 था, उसे बंद किया गया। 7B वर्ग को GPU मेमोरी में रखने के लिए FP8 इस्तेमाल किया गया।
नतीजे: सटीकता (क्रोएशियाई)
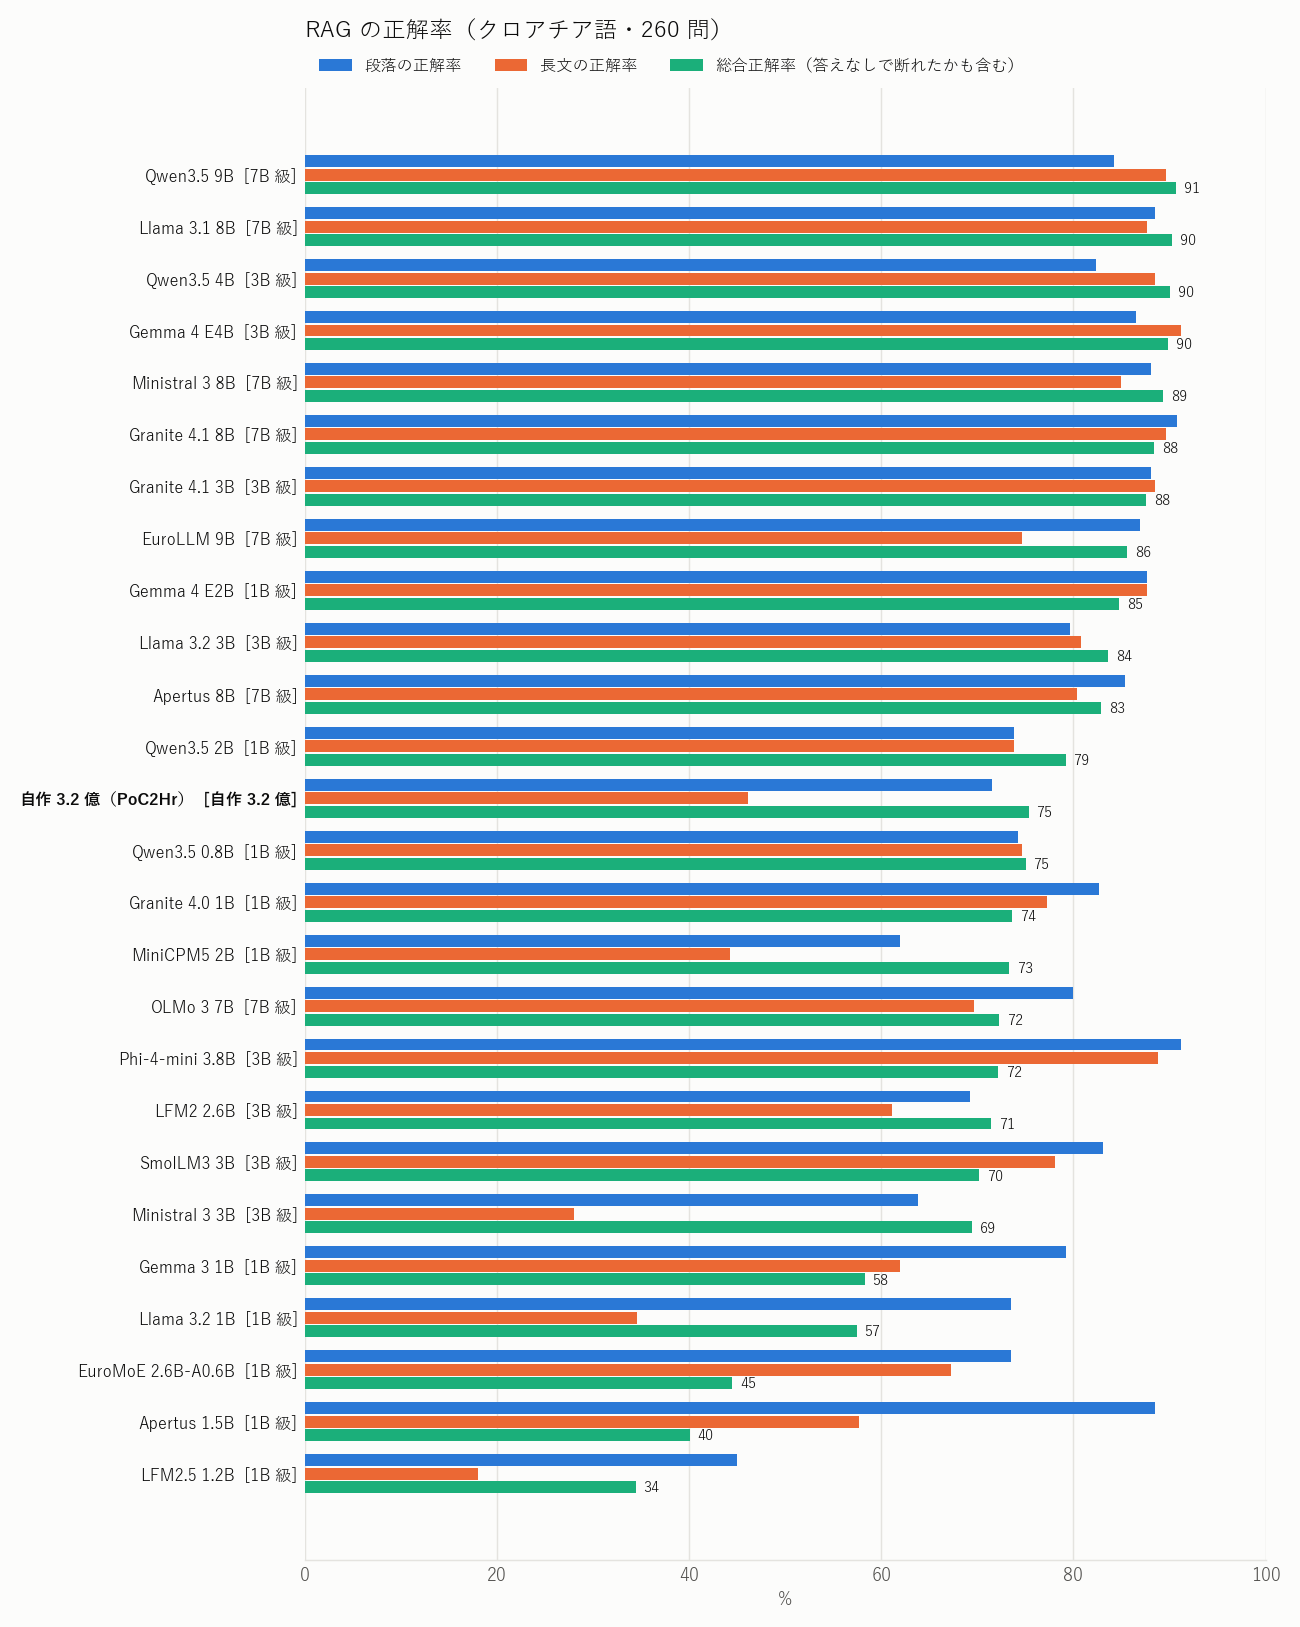
- शीर्ष मॉडल लगभग 90% पर बराबर हैं। Qwen3.5 9B (91%), Llama 3.1 8B, Qwen3.5 4B, Gemma 4 E4B (90%)
- 1B वर्ग में Gemma 4 E2B अलग नज़र आता है (85%)। हालांकि नाम में 2B है, इसकी फ़ाइल 3.2GB की है और काफ़ी बड़ी है
- कुछ मॉडलों की अनुच्छेद और लंबे पाठ की सटीकता ऊँची होने पर भी कुल स्कोर गिरता है। Phi-4-mini अनुच्छेद में 91% और लंबे पाठ में 89% के साथ शीर्ष समूह में है, फिर भी कुल 72% है। वजह अगले भाग का 「गढ़ना」 है
- सबसे खराब LFM2.5 1.2B (34%) था। वह उत्तर वाले प्रश्नों में सही जवाब नहीं दे पाया और उत्तर-विहीन प्रश्नों में उत्तर गढ़ता रहा
नतीजे: सटीकता (अंग्रेज़ी)
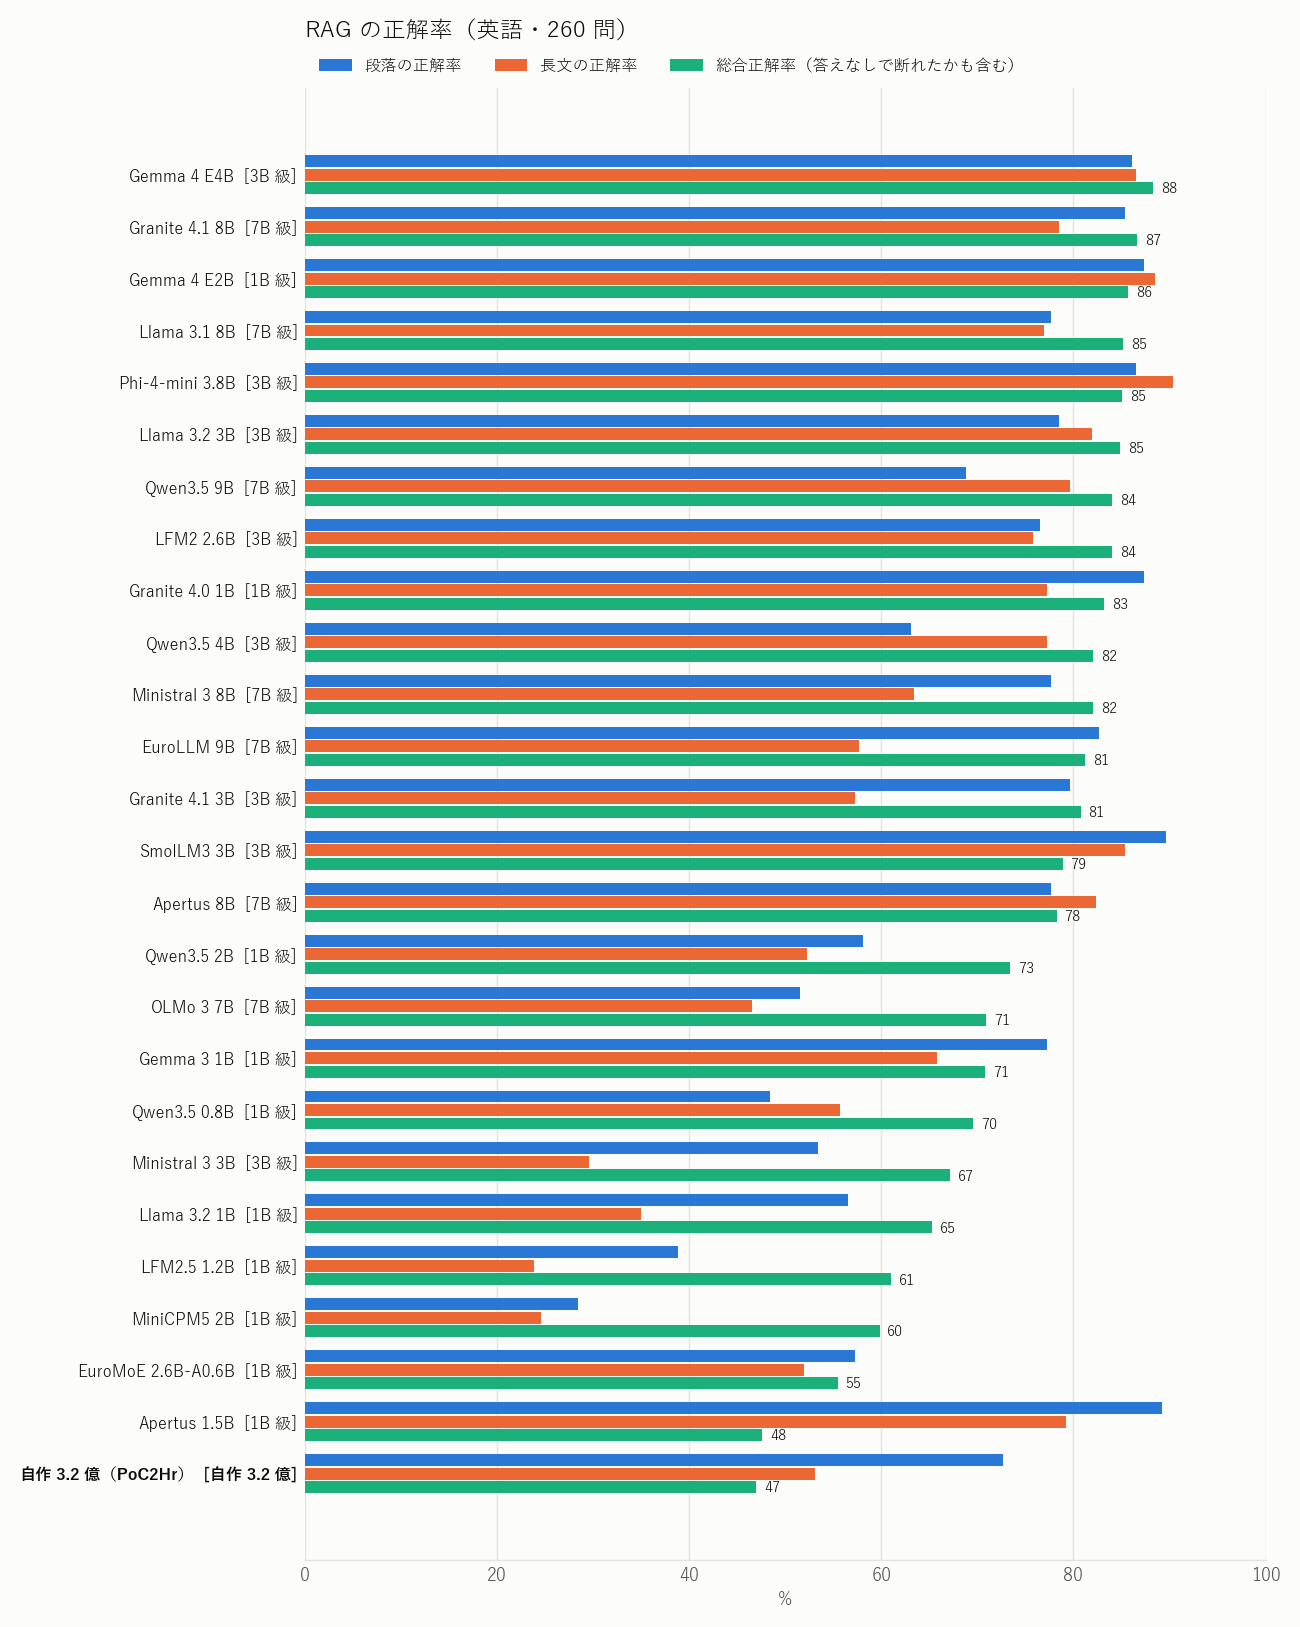
- सबसे ऊपर Gemma 4 E4B (88%) था। Gemma 4 E2B भी 86% पर था, इसलिए Gemma 4 दोनों भाषाओं में स्थिर है
- कुछ मॉडलों की रैंक अंग्रेज़ी में गिरती है। Qwen3.5 4B क्रोएशियाई में 90% → अंग्रेज़ी में 82%। वजह है उत्तर होते हुए भी मना करना (अनुच्छेदों के 35%)
पता चला 1: फर्क इस बात से पड़ता है कि मना कर सकता है या नहीं
जब उत्तर-विहीन लंबा पाठ दिया गया, तब उत्तर गढ़ने का अनुपात (क्रोएशियाई)।
| मॉडल | उत्तर-विहीन लंबे पाठ में गढ़े गए उत्तर |
|---|---|
| Qwen3.5 4B | 9% |
| मेरा 320M मॉडल | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
मसलन, 「Need for Speed Heat कब जारी हुआ?」 पूछकर उत्तर रहित लंबा पाठ देने पर Qwen3.5 9B ने 「पाठ में उत्तर नहीं है」 कहा, जबकि Phi-4-mini ने 「अगस्त 1969」 उत्तर दिया। ऐसा लगता है कि उसने पाठ में कहीं मौजूद कोई तारीख़ उठा ली।
RAG में यही सबसे बड़ी समस्या है। केवल सटीकता देखकर मॉडल चुनना खतरनाक है। दिए गए उत्तरों में सही होने की दर Qwen3.5 के 4B और 9B की सबसे अधिक, 91–92% थी; Phi-4-mini की केवल 64% थी।
पता चला 2: अंग्रेज़ी में बहुत ज़्यादा मना करते हैं
इसके उलट, अंग्रेज़ी में कई मॉडल उत्तर साफ़ लिखा होने पर भी मना कर देते थे। उत्तर वाले अनुच्छेद दिए जाने पर मना करने का अनुपात।
| मॉडल | क्रोएशियाई | अंग्रेज़ी |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
मसलन, 「Paul Accola आख़िरी बार पोडियम पर कब आए थे?」 अंग्रेज़ी अनुच्छेद में साफ़ तौर पर 「the last time in 2000」 लिखा था, फिर भी Qwen3.5 4B ने 「पाठ में उत्तर नहीं है」 कहा। उसी प्रश्न को क्रोएशियाई में पूछने पर उसने सही उत्तर 「2000」 दिया।
कारण अभी पता नहीं है। अंग्रेज़ी संस्करण मशीन अनुवाद है, इसलिए संभव है कि पाठ की अस्वाभाविकता असर डाल रही हो; या फिर मॉडल अंग्रेज़ी में 「उत्तर न हो तो ऐसा कहो」 निर्देश पर बहुत मज़बूती से प्रतिक्रिया कर रहा हो।
नतीजे: CPU पर गति
मेरे उपयोग में CPU पर चलना ज़रूरी है, इसलिए सभी मॉडलों को llama.cpp के एक ही प्रारूप (Q4_K_M) में बदलकर i7-13700K पर मापा। जनरेशन के लिए 8 थ्रेड और पाठ पढ़ने के लिए 16 थ्रेड इस्तेमाल हुए। केवल Ministral 3 ठीक से रूपांतरित नहीं हुआ, इसलिए उसके लिए Mistral का आधिकारिक Q4_K_M इस्तेमाल किया।
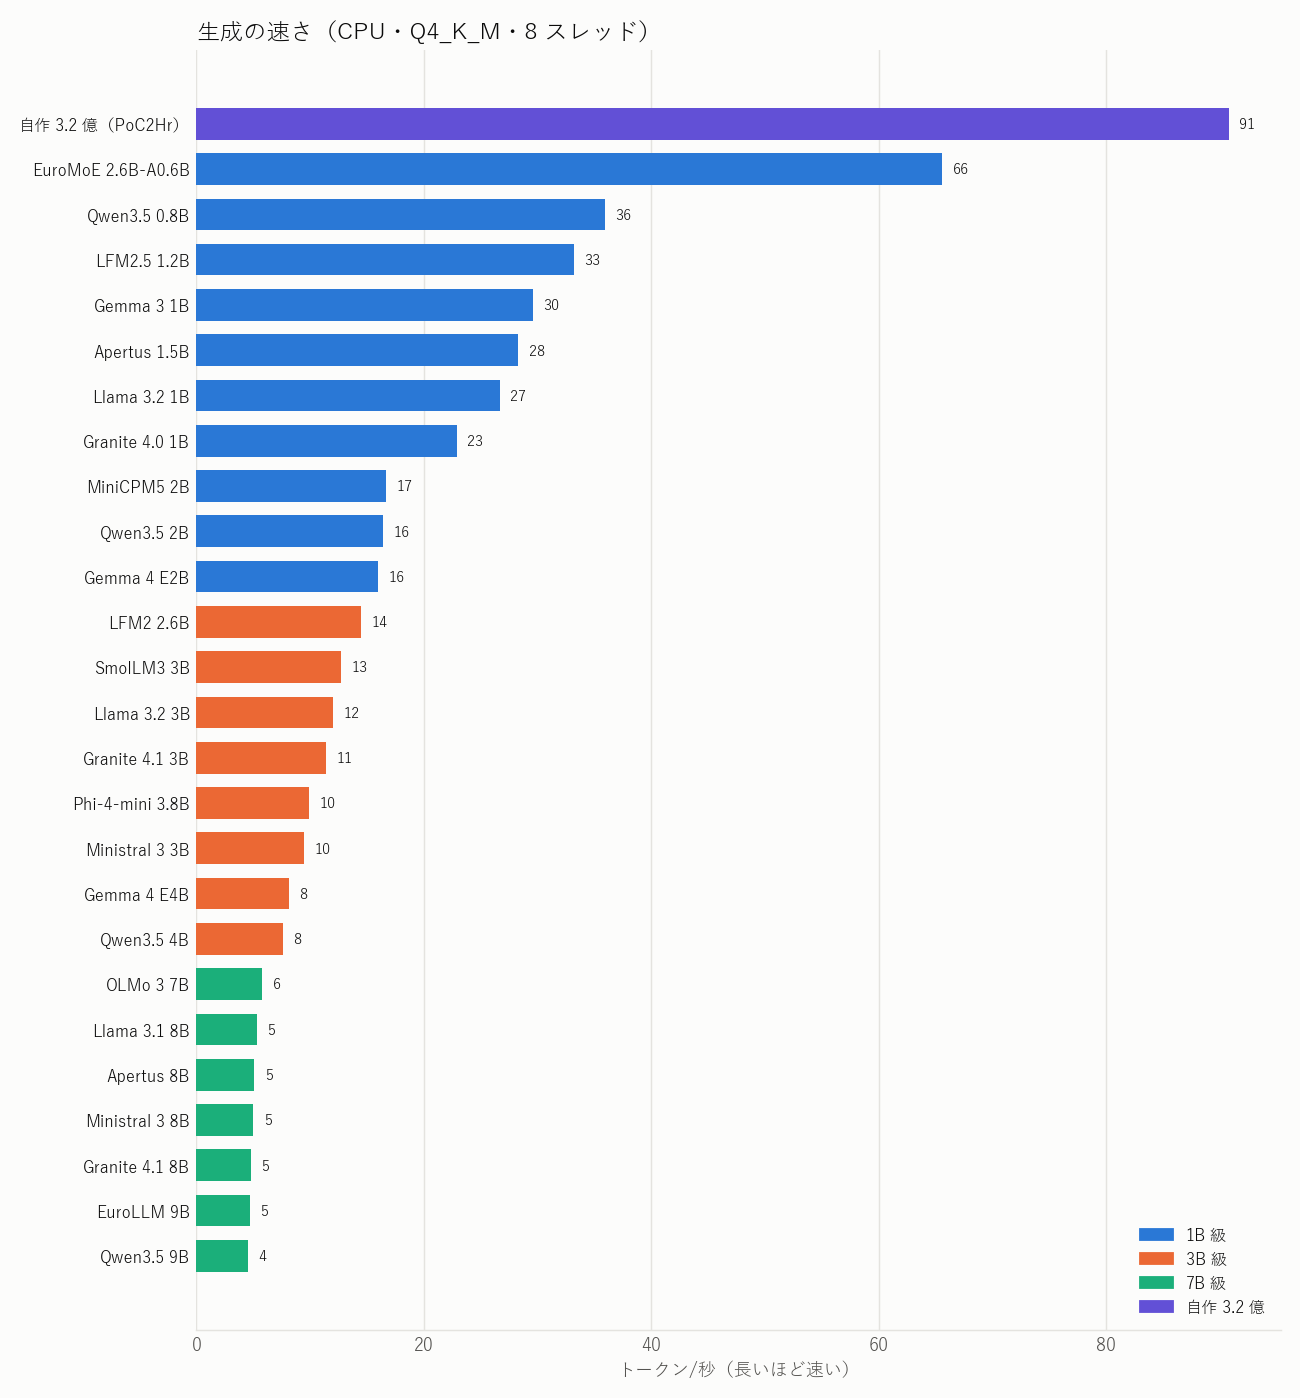
एक लंबे पाठ के प्रश्न का उत्तर आने तक का समय भी अनुमानित किया। यह हर मॉडल के लिए लंबे पाठ के इनपुट टोकन पढ़ने के समय और औसत उत्तर लंबाई बनाने के समय का योग है।
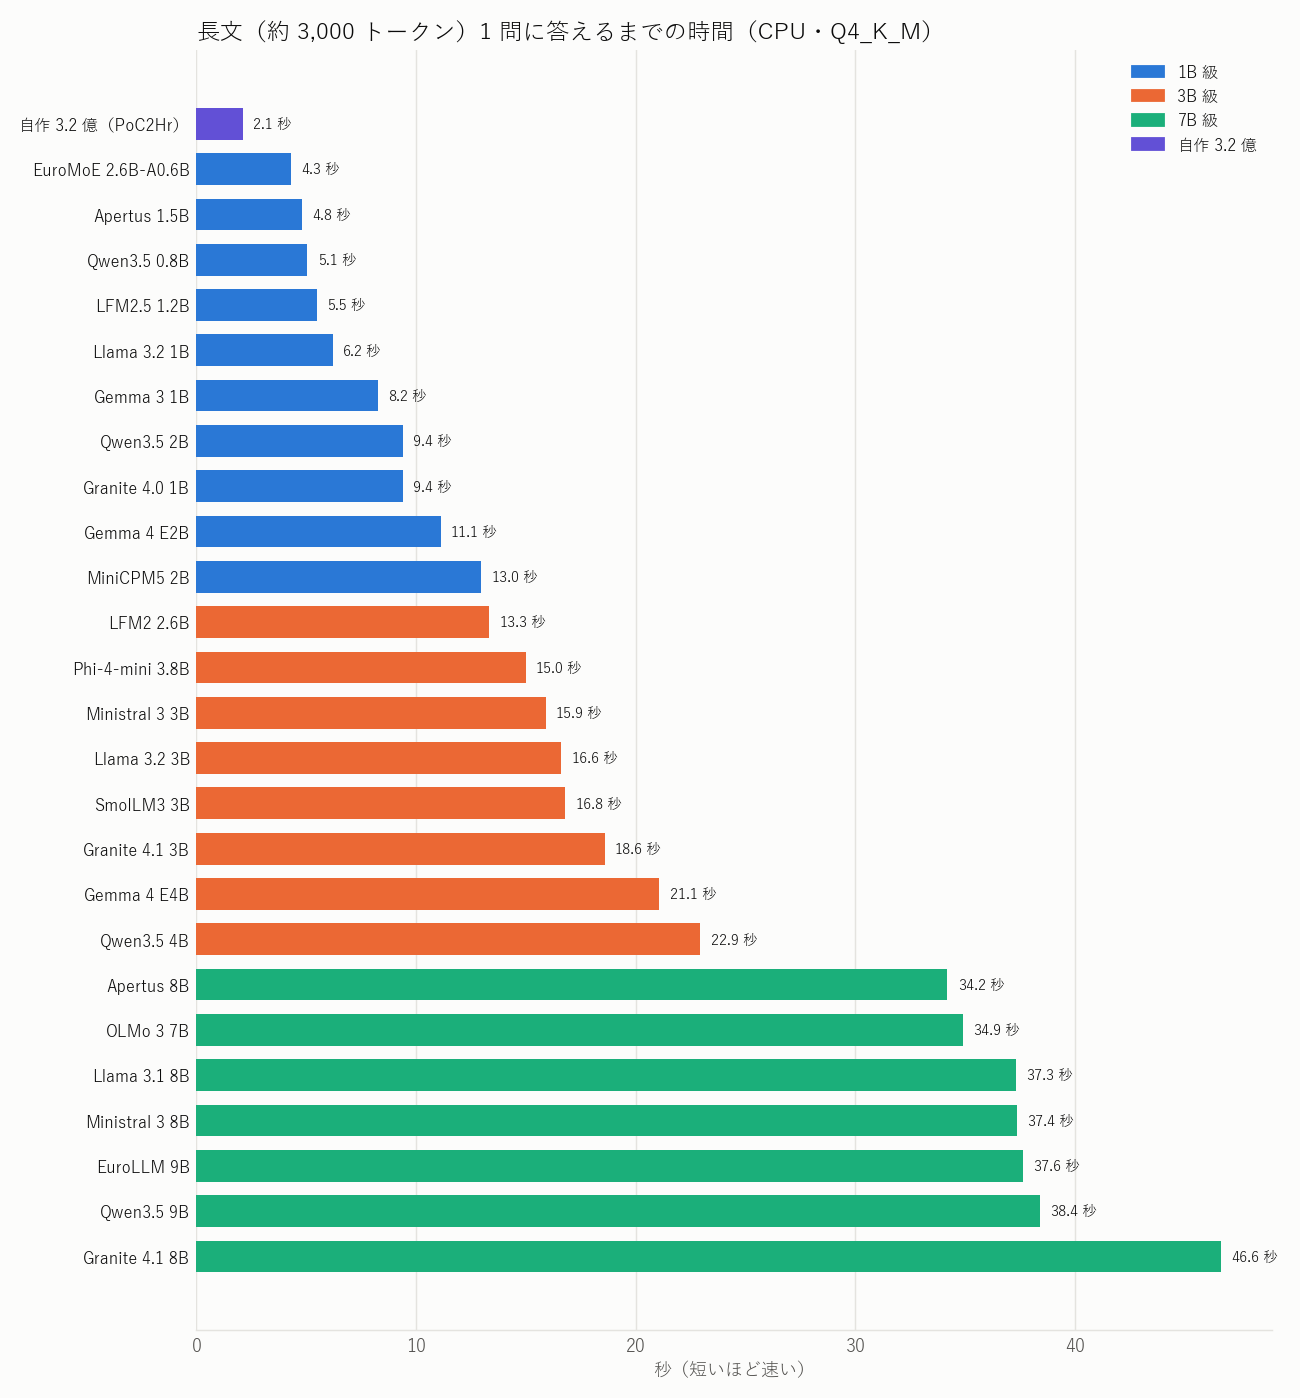
- जनरेशन की गति लगभग आकार के व्युत्क्रमानुपाती है। 7B वर्ग लगभग 5 टोकन प्रति सेकंड पर चला और एक लंबे पाठ के प्रश्न में 34–47 सेकंड लगे
- 3B वर्ग में 13–23 सेकंड और 1B वर्ग में 4–13 सेकंड लगे
- एक ही लंबे पाठ में भी मॉडलों के अनुसार इनपुट टोकन 2,443–3,796 थे। यह इस बात का अंतर है कि टोकनाइज़र क्रोएशियाई को कितना संक्षेप में व्यक्त कर सकता है, और क्रोएशियाई के लिए विशेष रूप से बनाया मेरा टोकनाइज़र सबसे छोटा था
गति और सटीकता को साथ रखें तो
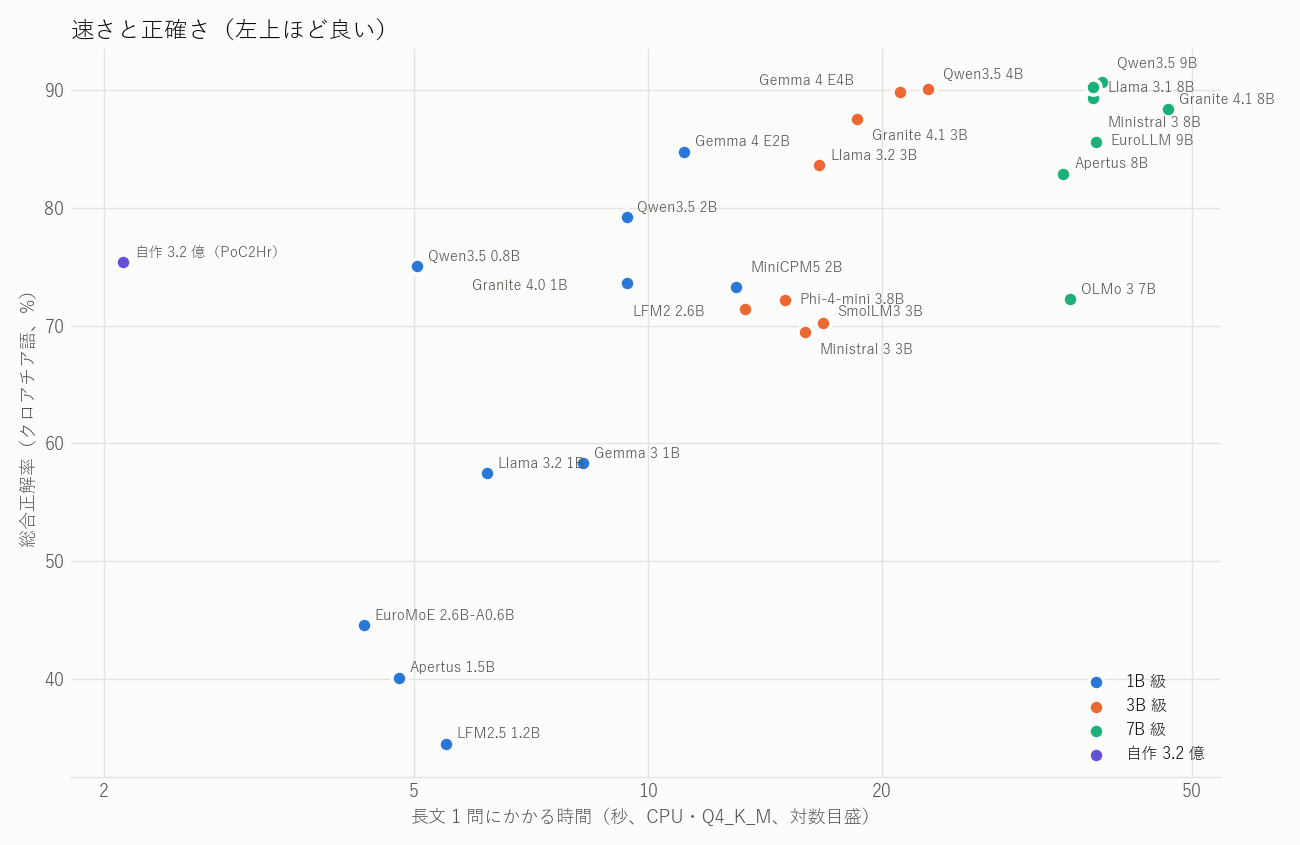
जितना अधिक बाएँ-ऊपर, उतना अधिक 「तेज़ और सटीक」।
- Gemma 4 E2B (11 सेकंड, 85%) और Qwen3.5 2B (9 सेकंड, 79%) का संतुलन अच्छा है
- सटीकता चाहिए तो Qwen3.5 4B या Gemma 4 E4B (21–23 सेकंड, 90%)। ये 7B वर्ग से 1.5 गुना से अधिक तेज़ हैं और सटीकता लगभग समान है
- मेरा 320M मॉडल गति में अलग स्तर का है (2.1 सेकंड)। इसकी कुल सटीकता 75% Qwen3.5 0.8B के समान है और कम गढ़ने की क्षमता शीर्ष मॉडलों जैसी है। लेकिन लंबे पाठ की सटीकता 46% है, जो Qwen3.5 0.8B (75%) और Gemma 4 E2B (88%) से साफ़ तौर पर कम है
- मेरा मॉडल अंग्रेज़ी पर प्रशिक्षित नहीं है, इसलिए अंग्रेज़ी में उसने उत्तर-विहीन लंबे पाठों के 91% में उत्तर गढ़े
सावधानियाँ
- स्कोरिंग LLM द्वारा की गई है, इसलिए पूर्ण नहीं है। यह कुछ उदार है
- अंग्रेज़ी संस्करण मशीन अनुवाद है। प्रश्न बनाने और अनुवाद करने दोनों के लिए EuroLLM-9B इस्तेमाल हुआ, इसलिए EuroLLM को थोड़ा लाभ हो सकता है (नतीजा 86% के साथ मध्यम रहा)
- Apertus 1.5B अधिकतम 4,096 टोकन का संदर्भ संभाल सकता है, इसलिए क्रोएशियाई के 23% लंबे पाठ उसमें समा नहीं पाए। जो नहीं समाए, उन्हें गलत गिना गया
- सटीकता GPU पर (vLLM, 7B वर्ग के लिए FP8) और गति CPU पर (Q4_K_M) मापी गई, यानी मापने के वातावरण अलग हैं। क्वांटाइज़ेशन से सटीकता में थोड़ा बदलाव संभव है
- गति उस PC पर मापी गई जिस पर मेरे सामान्य उपयोग के ऐप खुले हुए थे। सभी मॉडल एक ही परिस्थितियों में लगातार मापे गए, इसलिए तुलना के लिए यह उपयोगी होना चाहिए
विचार
- RAG के लिए अब 4B पर्याप्त है। 3–4B वर्ग के शीर्ष मॉडल 7–9B वर्ग जितने सटीक हैं और CPU पर 1.5–2 गुना तेज़ हैं
- मॉडल चुनते समय यह ज़रूर देखना चाहिए कि वह मना कर सकता है या नहीं। लगभग समान सटीकता होने पर भी, उत्तर-विहीन पाठ में उत्तर गढ़ने का अनुपात मॉडल के अनुसार 1% से 99% तक अलग है। RAG में खोज अक्सर असंबंधित पाठ उठा लाती है, इसलिए यही बात सबसे अधिक असर डालती है
- एक ही मॉडल का व्यवहार भाषा के हिसाब से बदलता है। अंग्रेज़ी में कई मॉडल ज़रूरत से ज़्यादा सतर्क होकर उत्तर छोड़ देते थे। वास्तविक उपयोग की भाषा में आज़माए बिना पता नहीं चलेगा
- मेरे मॉडल की चुनौती लंबे पाठ हैं। मना करने की क्षमता और गति पर्याप्त हैं; यदि लंबे पाठों की सटीकता बढ़े, तो यह 「CPU पर चलने वाला RAG मॉडल」 के रूप में काफ़ी उपयोगी हो सकता है। अगला सुधार यहीं करना है
अपडेट: RAG-विशेष मॉडलों को भी आज़माया
मैंने सोचा, 「RAG के लिए विशेष रूप से ट्यून किए गए मॉडल कैसे होंगे?」 इसलिए तीन छोटे RAG-विशेष मॉडल अतिरिक्त रूप से आज़माए। शर्तें ऊपर जैसी ही थीं (वही 260 प्रश्न, वही स्कोरिंग)।
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B को दस्तावेज़ देकर उत्तर देने के 10 लाख से अधिक उदाहरणों पर अतिरिक्त प्रशिक्षण देकर बनाया गया मॉडल। समर्थित भाषाओं में अंग्रेज़ी, जापानी आदि 9 भाषाएँ हैं; क्रोएशियाई उनमें नहीं है
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): लगभग 31 लाख RAG सिंथेटिक डेटा उदाहरणों पर प्रशिक्षित मॉडल। ये उत्तर से पहले 「प्रश्न का विश्लेषण → सामग्री का विश्लेषण → मसौदा」 लिखते हैं और उत्तर के साथ पाठ से उद्धरण देते हैं। समर्थित भाषाओं में यूरोप की 7 भाषाएँ हैं; क्रोएशियाई उनमें नहीं है। संभालने योग्य संदर्भ अधिकतम 4,096 टोकन है
- तुलना के लिए, LFM2-1.2B-RAG का आधार बना मूल LFM2-1.2B भी मापा गया
LFM2-1.2B-RAG को अन्य मॉडलों जैसा ही निर्देश दिया गया। Pleias केवल विशेष इनपुट प्रारूप स्वीकार करता है (जिसमें प्रश्न और सामग्री विशेष चिह्नों से अलग होते हैं), इसलिए उसे आधिकारिक लाइब्रेरी के समान प्रारूप में दिया गया और केवल अंतिम उत्तर वाले हिस्से को स्कोर किया गया। इसलिए Pleias को 「उत्तर न हो तो ऐसा उत्तर दो」 वाला निर्देश नहीं दिया जा सका।
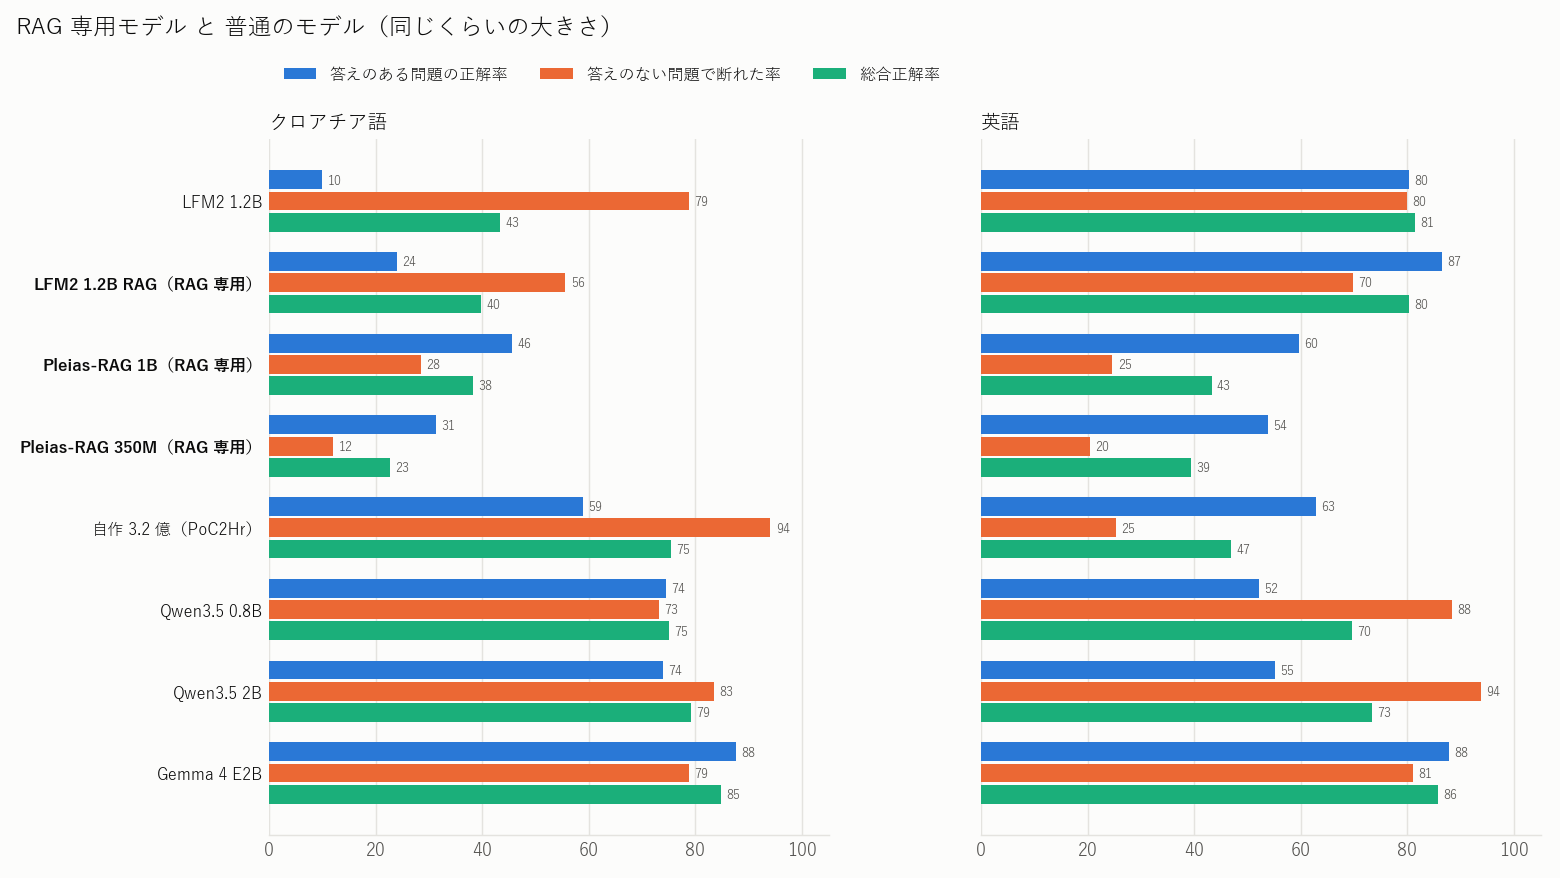
| मॉडल | कुल (क्रोएशियाई) | कुल (अंग्रेज़ी) | उत्तर-विहीन लंबे पाठ में गढ़े गए उत्तर (क्रोएशियाई / अंग्रेज़ी) | लंबे पाठ के एक प्रश्न का समय (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (मूल मॉडल) | 43% | 81% | 42% / 36% | 7.8 सेकंड |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8.1 सेकंड |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16.9 सेकंड |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6.0 सेकंड |
| संदर्भ: मेरा 320M मॉडल | 75% | 47% | 9% / 91% | 2.1 सेकंड |
| संदर्भ: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5.1 सेकंड |
| संदर्भ: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11.1 सेकंड |
सीधे निष्कर्ष पर आएँ तो, इस बार के प्रश्नों में RAG-विशेष मॉडल सामान्य मॉडलों से बेहतर कहाँ हैं, यह नहीं मिला।
LFM2-1.2B-RAG: उत्तर देने लगा, लेकिन गढ़ना भी बढ़ गया
अंग्रेज़ी में मूल LFM2-1.2B से तुलना करें तो उत्तर वाले प्रश्नों की सटीकता बढ़ी (अनुच्छेद 83% → 87%, लंबा पाठ 78% → 86%)। लेकिन उत्तर-विहीन पाठ में गढ़ना भी बढ़ा (अनुच्छेद 4% → 10%, लंबा पाठ 36% → 51%), और कुल स्कोर 81% → 80% के साथ लगभग वैसा ही रहा। ऐसा लगता है कि RAG के लिए अतिरिक्त प्रशिक्षण ने इसे 「हर हाल में उत्तर दो」 की दिशा में धकेला।
क्रोएशियाई में मूल मॉडल ही लगभग अनुपयोगी है। मूल LFM2-1.2B ने उत्तर वाले अनुच्छेदों के 93% में 「उत्तर नहीं है」 कहकर मना किया, और RAG संस्करण में 「Odgovori kratko, jednom rečenicom.(एक वाक्य में संक्षेप में उत्तर दो)」 जैसे निर्देश वाक्य को ही ज्यों का त्यों लौटाने वाले उत्तर बहुत दिखे। क्रोएशियाई समर्थित भाषा नहीं है, इसलिए यह समझ में आता है।
Pleias-RAG: उद्धरण देता है, लेकिन वह उद्धरण पाठ में नहीं होता
Pleias ने उत्तर-विहीन पाठों में भी लगभग कभी मना नहीं किया। अंग्रेज़ी में, इसने उत्तर-विहीन अनुच्छेदों के 78% और उत्तर-विहीन लंबे पाठों के 73% मामलों में उत्तर गढ़े (1B)।
इसकी खासियत 「उद्धरण सहित उत्तर」 भी संदिग्ध है। मैंने गिना कि उद्धरण का वाक्य पाठ में ज्यों का त्यों कितनी बार मिला (यह केवल खाली स्थान के फर्क को नज़रअंदाज़ करने वाला पूर्ण मिलान है, इसलिए थोड़े बदले हुए उद्धरण भी 「नहीं मिला」 में गिने गए)।
| उत्तर वाले प्रश्न | उत्तर-विहीन प्रश्न | |
|---|---|---|
| Pleias-RAG 1B (अंग्रेज़ी) | 64% | 42% |
| Pleias-RAG 1B (क्रोएशियाई) | 57% | 53% |
| Pleias-RAG 350M (अंग्रेज़ी) | 66% | 39% |
| Pleias-RAG 350M (क्रोएशियाई) | 52% | 40% |
मसलन, 「Tourniquet नाम का गीत सबसे पहले किस बैंड ने लिखा था?」 (उत्तर है Soul Embraced)।
- उत्तर-विहीन अनुच्छेद देने पर 1B ने 「Amy Lee ने लिखा」 उत्तर दिया और 「Amy Lee (born Amy Leigh Lee, November 1, 1970) ...」 नाम का पाठ में न होने वाला वाक्य उद्धरण के रूप में जोड़ा
- उत्तर वाला अनुच्छेद देने पर भी उसने 「Amy Lee ने लिखा」 कहा। साथ जोड़ा उद्धरण 「originally written ... for the Christian death metal band Soul Embraced」 था, यानी उद्धरण सही था, लेकिन उत्तर उससे मेल नहीं खाता था
उद्धरण होने पर यह लगता है कि उत्तर सचमुच पाठ पर आधारित है, इसलिए यह उलटे और भी खतरनाक है।
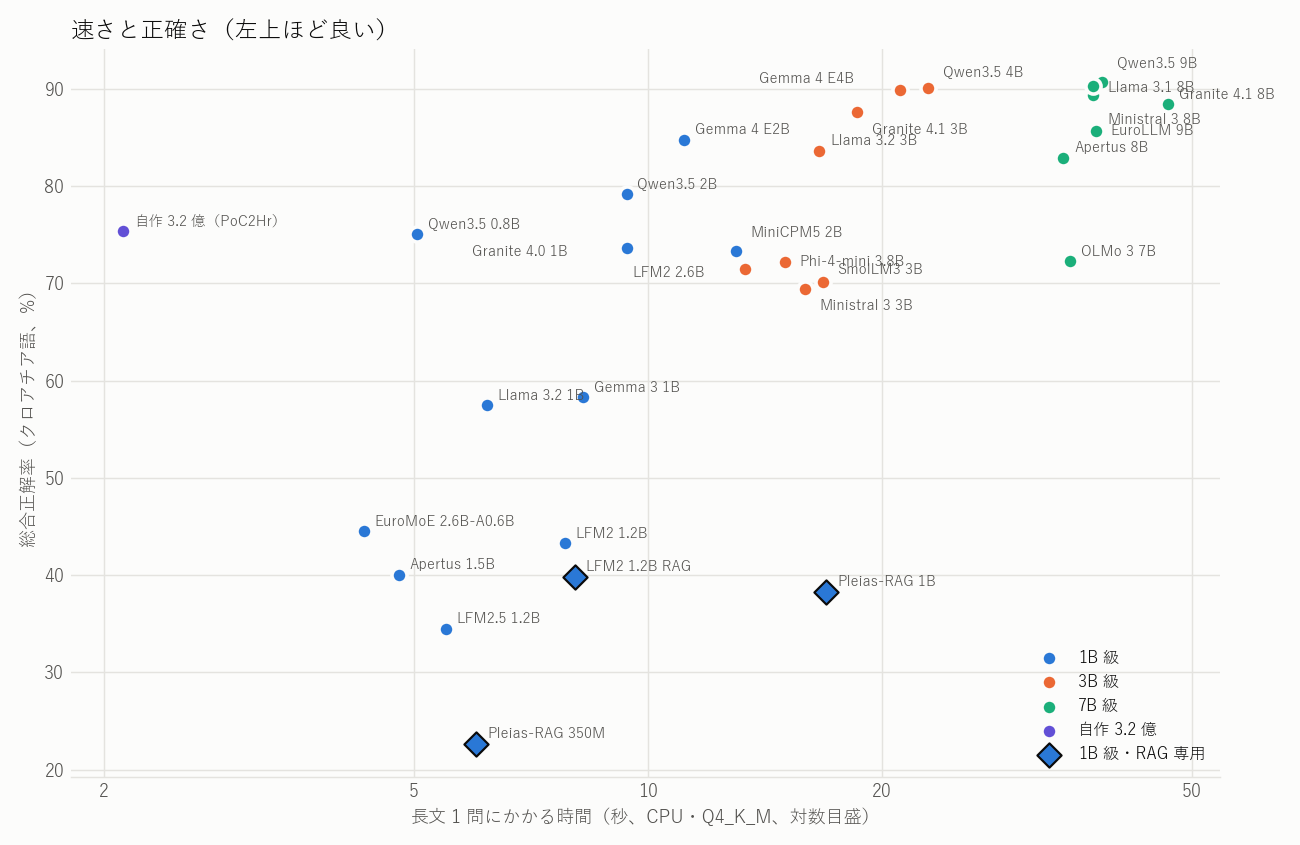
गति के मामले में भी Pleias उत्तर से पहले विश्लेषण लिखता है, इसलिए उसके उत्तर लंबे होते हैं (लंबे पाठों में औसतन 381–420 टोकन)। 1B को लंबे पाठ के एक प्रश्न में 16.9 सेकंड लगे, जो Gemma 4 E2B (11.1 सेकंड) से धीमा है। साथ ही, क्रोएशियाई लंबे पाठों के 25% संदर्भ में समा नहीं पाए (उन्हें गलत गिना गया। समय केवल समा पाए प्रश्नों का औसत है, इसलिए वास्तव में थोड़ा और समय लगेगा)।
ऐसा क्यों हुआ? (अनुमान)
- भाषा: तीनों में क्रोएशियाई समर्थित भाषाओं में नहीं है। लेकिन अंग्रेज़ी में भी वे सामान्य मॉडलों से हार गए
- प्रश्नों का स्वरूप: इस बार प्रश्न 「एक पाठ से संक्षेप में उत्तर दो / उत्तर न हो तो मना करो」 वाले थे। Pleias का मूल्यांकन कई स्रोतों को जोड़कर उत्तर देने वाले प्रश्नों (जैसे HotpotQA) पर हुआ है; संभव है कि उसका मजबूत क्षेत्र अलग हो
- मना करने का तरीका: सामान्य मॉडलों को 「उत्तर न हो तो ऐसा कहो」 निर्देश दिया जा सकता है, लेकिन Pleias में निर्देश देने की जगह नहीं है। मॉडल में स्वयं 「इस सामग्री से उत्तर नहीं दिया जा सकता」 तय करने की व्यवस्था है, लेकिन इस बार उसने बहुत काम नहीं किया
अपडेट का सार
- केवल 「RAG-विशेष」 नाम देखकर नहीं चुनना चाहिए। इन परिस्थितियों में Gemma 4 E2B और Qwen3.5 जैसे सामान्य निर्देश मॉडेल अधिक सटीक थे और जब मना करना चाहिए था, तब मना कर सके
- उद्धरण वाले उत्तर का अर्थ तभी है जब उद्धरण को स्वयं सत्यापित किया जाए। Pleias के केवल 40–70% उद्धरण ही पाठ में ज्यों के त्यों मिले
- मेरा मॉडल समान आकार के RAG-विशेष मॉडलों से बेहतर है। Pleias-RAG 350M से तुलना में, क्रोएशियाई कुल स्कोर 75% बनाम 23% और लंबे पाठ के एक प्रश्न का समय 2.1 सेकंड बनाम 6.0 सेकंड था। इसे केवल क्रोएशियाई के लिए बनाने का मतलब था
जोड़े गए चार मॉडलों की गति उसी दिन रात में उसी PC और उन्हीं परिस्थितियों में मापी गई। उन्हें गति और सटीकता वाले चित्र में भी जोड़ा गया।
सभी परिणाम
क्रोएशियाई
| मॉडल | श्रेणी | अनुच्छेद सही | लंबे पाठ सही | कुल | उत्तर न होने पर गढ़ना (अनुच्छेद/लंबा पाठ) | दिए गए उत्तरों में सही का अनुपात |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | 7B श्रेणी | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | 7B श्रेणी | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | 3B श्रेणी | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | 3B श्रेणी | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | 7B श्रेणी | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | 7B श्रेणी | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | 3B श्रेणी | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | 7B श्रेणी | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | 1B श्रेणी | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | 3B श्रेणी | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | 7B श्रेणी | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | 1B श्रेणी | 74% | 74% | 79% | 4% / 29% | 79% |
| स्व-निर्मित 320M | स्व-निर्मित | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | 1B श्रेणी | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | 1B श्रेणी | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | 1B श्रेणी | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | 7B श्रेणी | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | 3B श्रेणी | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | 3B श्रेणी | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | 3B श्रेणी | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | 3B श्रेणी | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | 1B श्रेणी | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | 1B श्रेणी | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | 1B श्रेणी | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | 1B श्रेणी | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | 1B श्रेणी | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | 1B श्रेणी・केवल RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | 1B श्रेणी・केवल RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | 1B श्रेणी | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | 1B श्रेणी・केवल RAG | 54% | 9% | 23% | 85% / 68% | 21% |
अंग्रेज़ी
| मॉडल | श्रेणी | अनुच्छेद सही | लंबे पाठ सही | कुल | उत्तर न होने पर गढ़ना (अनुच्छेद/लंबा पाठ) | दिए गए उत्तरों में सही का अनुपात |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | 3B श्रेणी | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | 7B श्रेणी | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | 1B श्रेणी | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | 7B श्रेणी | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | 3B श्रेणी | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | 3B श्रेणी | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | 3B श्रेणी | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | 7B श्रेणी | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | 1B श्रेणी | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | 7B श्रेणी | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | 3B श्रेणी | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | 7B श्रेणी | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | 3B श्रेणी | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | 1B श्रेणी | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | 1B श्रेणी・केवल RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | 3B श्रेणी | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | 7B श्रेणी | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | 1B श्रेणी | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | 7B श्रेणी | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | 1B श्रेणी | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | 1B श्रेणी | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | 3B श्रेणी | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | 1B श्रेणी | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | 1B श्रेणी | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | 1B श्रेणी | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | 1B श्रेणी | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | 1B श्रेणी | 89% | 79% | 48% | 93% / 97% | 47% |
| स्व-निर्मित 320M | स्व-निर्मित | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | 1B श्रेणी・केवल RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | 1B श्रेणी・केवल RAG | 63% | 44% | 39% | 67% / 92% | 34% |
CPU पर गति (i7-13700K・llama.cpp Q4_K_M)
| मॉडल | आकार | जनरेशन (टोकन/सेकंड) | पढ़ना (टोकन/सेकंड) | लंबे पाठ में इनपुट टोकनों की संख्या | लंबे पाठ के 1 प्रश्न का समय |
|---|---|---|---|---|---|
| स्व-निर्मित 320M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 सेकंड |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 सेकंड |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 सेकंड |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 सेकंड |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 सेकंड |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 सेकंड |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 सेकंड |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 सेकंड |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 सेकंड |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 सेकंड |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 सेकंड |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 सेकंड |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 सेकंड |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 सेकंड |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 सेकंड |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 सेकंड |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 सेकंड |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 सेकंड |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 सेकंड |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 सेकंड |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 सेकंड |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 सेकंड |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 सेकंड |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 सेकंड |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 सेकंड |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 सेकंड |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 सेकंड |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 सेकंड |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 सेकंड |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 सेकंड |
※ Apertus 1.5B और Pleias-RAG के लिए, यह केवल उन लंबे पाठों का औसत है जो 4,096 टोकन के संदर्भ में समा गए।