क्रोएशियाई RAG के लिए 30 करोड़ पैरामीटर वाला LLM शून्य से बनाया — CPU पर चलता है
पिछली बार के GPT-2 के बाद, इस बार मैंने एक RTX 4090 पर क्रोएशियाई LLM को शून्य से बनाया। मकसद था RAG: दिए गए पाठ में से उत्तर ढूँढना और उसके समर्थन में एक वाक्य उद्धृत करते हुए जवाब देना। और इसे प्रोडक्शन में CPU पर चलाने के लिए बनाया गया है।
पहले निष्कर्ष।
- शून्य से पूरा होने तक GPU पर लगभग 68 घंटे (प्रयोग-त्रुटि सहित)। इनमें प्री-ट्रेनिंग में 51 घंटे लगे
- 32 करोड़ पैरामीटर। अनुच्छेद-आधारित प्रश्नों में 71%, और 3,000-टोकन स्तर के लंबे पाठ में 44% सही
- केवल CPU पर एक प्रश्न का उत्तर 3–16 सेकंड में देता है। टेक्स्ट निकलने की गति आंखों से साफ़ देखी जा सकती है
प्रशिक्षण में लगा समय
| चरण | समय | विवरण |
|---|---|---|
| प्रशिक्षण डेटा निर्माण | लगभग 4.5 घंटे | EuroLLM-9B (vLLM) से Wikipedia के 45,000 QA और बातचीत के 50,000 अनुवाद |
| टोकनाइज़र और टोकनीकरण | लगभग 2.5 घंटे (CPU) | क्रोएशियाई के लिए 32,000 शब्दावली वाला अपना टोकनाइज़र बनाया |
| प्री-ट्रेनिंग | 50 घंटे 46 मिनट | 7 अरब टोकन। अंतिम 10% में संदर्भ लंबाई बढ़ाकर 4,096 की |
| SFT | लगभग 35 मिनट | उद्धरण सहित उत्तर देना और उत्तर न होने पर मना करना सिखाया |
| रिइनफोर्समेंट लर्निंग (GRPO) | लगभग 11 घंटे | 400 स्टेप + समायोजन के बाद 300 स्टेप |
अपना टोकनाइज़र क्रोएशियाई को GPT-2 के टोकनाइज़र की लगभग आधी टोकन संख्या में व्यक्त कर सकता है। 4,096 टोकन में लगभग 17,000 अक्षर पढ़े जा सकते हैं।
बना हुआ मॉडल
| मद | विवरण |
|---|---|
| पैरामीटर | 32 करोड़ (24 लेयर, 1024 डायमेंशन) |
| संरचना | Llama / Qwen3 श्रेणी (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| संदर्भ लंबाई | 4,096 टोकन |
| आउटपुट प्रारूप | उत्तर + Izvor: „संदर्भ से ज्यों का त्यों निकाला गया 1 वाक्य“। उत्तर न होने पर U tekstu nema odgovora na ovo pitanje.(पाठ में इस प्रश्न का उत्तर नहीं है) |
| निष्पादन | CPU को ध्यान में रखकर (fp32 में लगभग 1.3GB) |
इसके अलावा, बाहर एक ऐसा तंत्र जोड़ा गया जो प्रोग्राम से जांचता है कि बनाया गया उद्धरण सचमुच संदर्भ में मौजूद है या नहीं; न होने पर उसे “उत्तर नहीं है” से बदल देता है। मॉडल पर पूरी तरह भरोसा करने के बजाय, आधार को जांचने योग्य बनाना महत्वपूर्ण है।
बनाते समय सामने आई समस्याएँ
1. उत्तर न होने पर भी हर बार गढ़ देता है। शुरुआत में मैंने बस सामान्य प्रश्नोत्तर सिखाया। सटीकता बढ़ी, लेकिन उत्तर-विहीन पाठ देने पर उसने 100% बार विश्वसनीय लगने वाला उत्तर गढ़ा। RAG में यही सबसे बड़ी परेशानी है। फिर उद्धरण और “मना करना” सिखाया, तो गढ़े हुए उत्तर कुछ प्रतिशत तक घट गए।
2. जरूरत से ज़्यादा मना करता है। रिइनफोर्समेंट लर्निंग में स्कोरिंग को “गलत होने पर −0.5, मना करने पर 0” रखा, तो उसने सीखा कि कठिन लंबे पाठों में मना करके बच निकलना फ़ायदेमंद है, और 70% बार मना करने लगा। स्कोरिंग नियम की कमी को उसने बखूबी पकड़ लिया। मना करने पर −0.3 करने पर यह उलटी दिशा में चला गया: उसने लगभग मना करना बंद कर दिया और गढ़े हुए उत्तर 40% तक पहुंच गए। यह झूले की तरह इधर-उधर होता रहा।
3. उद्धरण की नकल में गलती। लंबे पाठ में उत्तर सही होने पर भी वह उद्धरण में शब्दों का क्रम बदल देता है या लेख का पहला वाक्य उठा लेता है। लंबे संदर्भ में उद्धरण भी सही होने की दर करीब आधी थी।
4. सत्यापन से बच निकलने वाली गलती। संदर्भ में मिलाए गए किसी दूसरे लेख के “〇〇 में जन्म हुआ” वाले वाक्य को ठीक-ठीक उद्धृत करके उसने किसी दूसरे व्यक्ति का जन्मस्थान बता दिया। उद्धरण असली है, इसलिए सत्यापन उसे रोक नहीं सकता।
5. मूल्यांकन डेटा की कमी। कुछ मामलों में, जिन्हें “उत्तर-विहीन संदर्भ” होना चाहिए था, उत्तर का एक भाग बचा रह गया था; मॉडल सही था लेकिन उसे “गढ़ा हुआ” करार दिया गया।
अंतिम प्रदर्शन
हर श्रेणी में 300 प्रश्नों का मूल्यांकन। समायोजित रिइनफोर्समेंट लर्निंग के 100वें स्टेप वाले मॉडल का इस्तेमाल किया गया, जिसमें मना करने और उत्तर देने का संतुलन सबसे अच्छा था।
| संदर्भ | सही | गलत | मना किया |
|---|---|---|---|
| अनुच्छेद (लगभग 100–400 टोकन) | 71.3% | 16.7% | 12.0% |
| लंबा संदर्भ (1,500–3,500 टोकन) | 44.0% | 20.3% | 35.7% |
| उत्तर-विहीन संदर्भ | सही ढंग से मना किया | गढ़ा हुआ उत्तर |
|---|---|---|
| अनुच्छेद | 97.7% | 2.3% |
| लंबा संदर्भ | 92.3% | 7.7% |
सत्यापन से गुजरने के बाद “दिए गए उत्तरों में सही उत्तरों का अनुपात” 73.8% था। 90% के लक्ष्य से अभी काफी दूर है।
वैसे, यदि एक प्रश्न को 8 बार हल कराया जाए और उनमें से एक बार भी सही हो तो OK माना जाए, तो अनुच्छेदों में 91% और लंबे पाठों में 74% तक हल हो रहे थे (अंतिम चेकपॉइंट पर मापा गया)। रिइनफोर्समेंट लर्निंग के पहले और बाद में यह संख्या लगभग नहीं बदली; बदला यह कि “हर बार हल हो पा रहा है या नहीं।” आंकड़ों से साफ़ हुआ कि रिइनफोर्समेंट लर्निंग नई क्षमता जोड़ने से अधिक, जो समस्याएँ कभी-कभार हल होती हैं उन्हें हर बार हल करवाने का काम करती है।
CPU पर चलाकर देखा
परीक्षण के लिए Web UI बनाया और इसे सिर्फ़ CPU (i7-13700K) पर चलाया। टेक्स्ट निकलने की गति ही जनरेशन स्पीड है।
अनुच्छेद (263 टोकन): पहले अक्षर तक 0.3 सेकंड, लगभग 11 टोकन/सेकंड, कुल 7 सेकंड
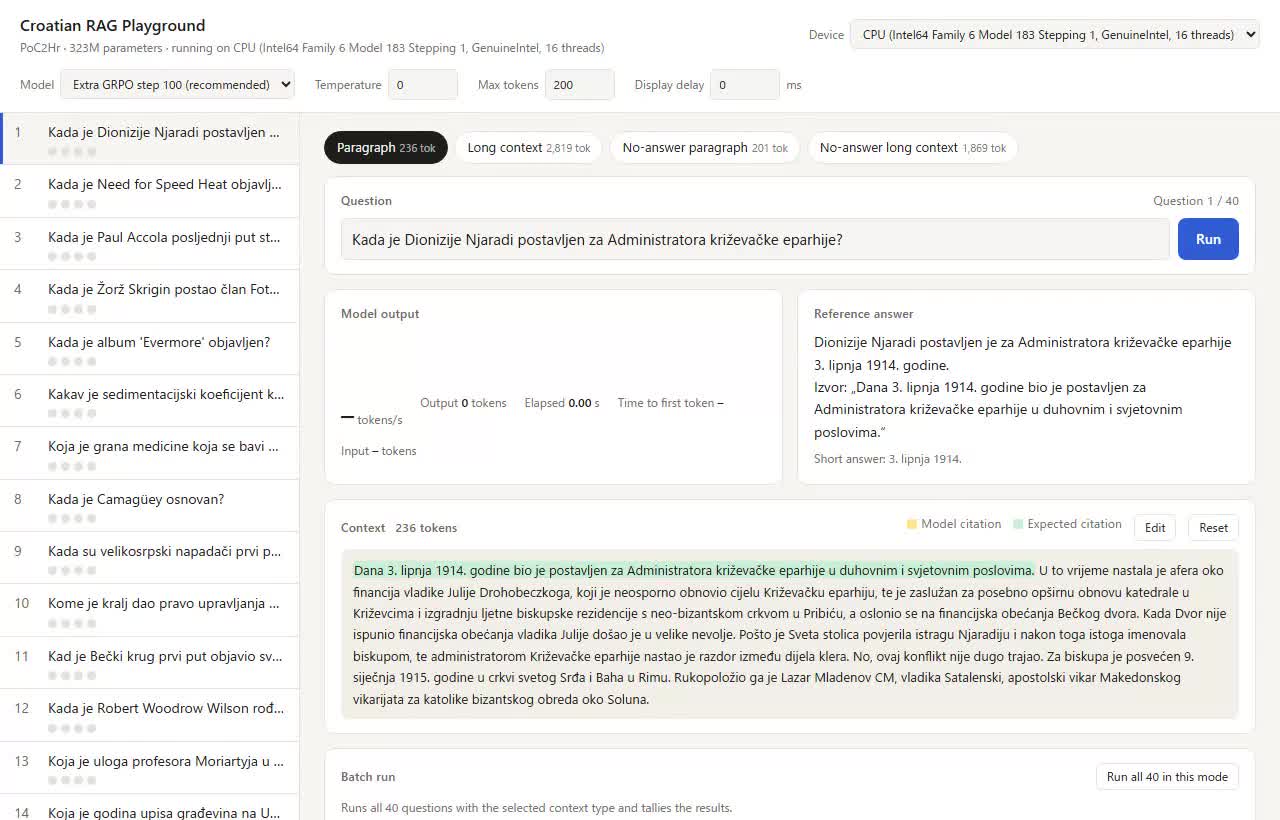
लंबा संदर्भ (3,215 टोकन): पाठ पढ़ने में लगभग 5 सेकंड, लगभग 5 टोकन/सेकंड, कुल 19 सेकंड। पीला हिस्सा उद्धृत वाक्य है; इसने 3,000 टोकन में से सही एक वाक्य ढूँढ लिया है
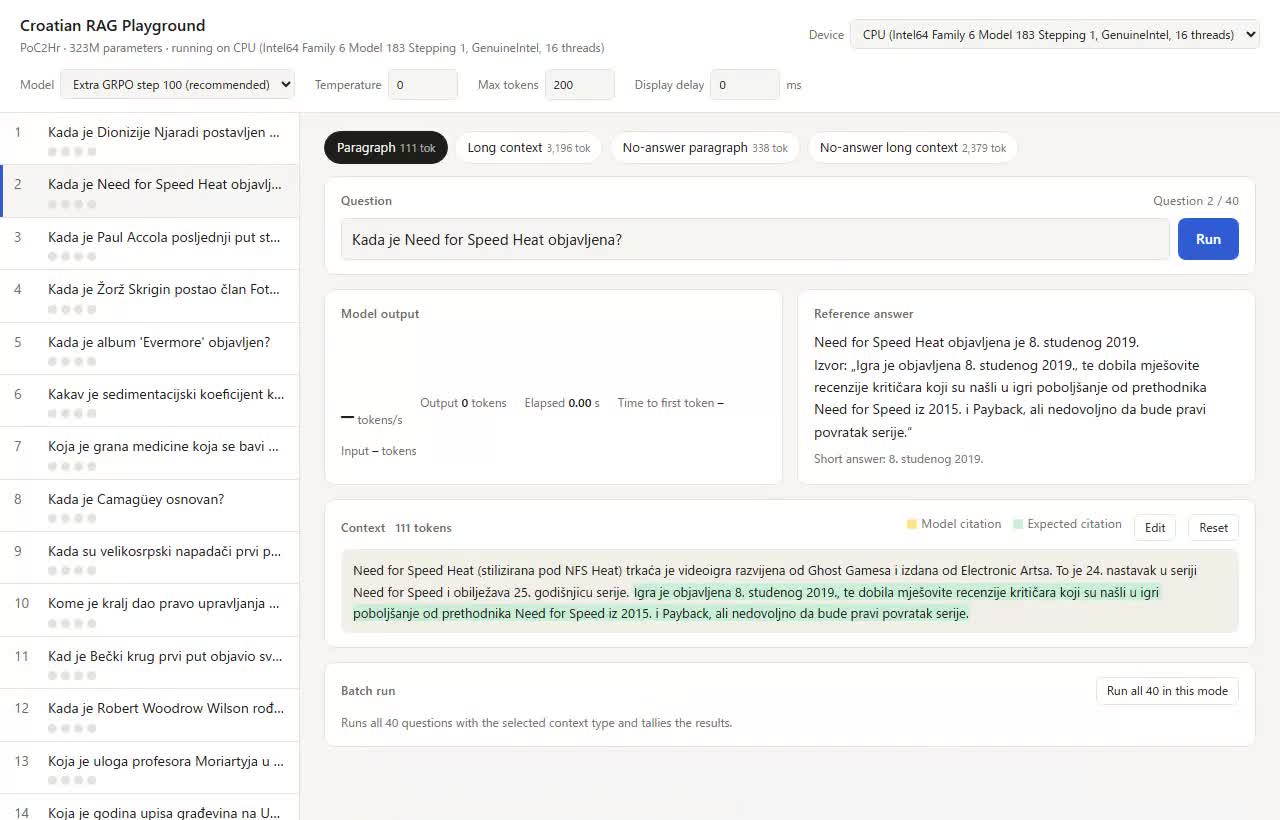
वीडियो रिकॉर्ड करते समय बनाया गया था, इसलिए थोड़ा धीमा है। बिना रिकॉर्डिंग के 20-20 प्रश्न मापने पर, अनुच्छेदों में 15 टोकन/सेकंड और 3.4 सेकंड प्रति प्रश्न; लंबे संदर्भ में 7 टोकन/सेकंड और 16 सेकंड प्रति प्रश्न लगे। उत्तर लगभग 50 टोकन के छोटे हैं, इसलिए CPU पर भी गति व्यावहारिक लगती है।
विचार
- छोटे मॉडल को “मुझे नहीं पता कि मुझे क्या नहीं पता” कहना सिखाना सबसे महत्वपूर्ण है। RAG में सटीकता बढ़ाने से ज़्यादा असर गढ़े हुए उत्तर घटाने का है। उद्धरण + मना करना + बाहर से सत्यापन का संयोजन काफी प्रभावी रहा
- 32 करोड़ पर लंबे पाठ सीमा बन जाते हैं। 8 बार हल कराने पर भी लंबे पाठ सिर्फ़ 74% तक पहुंचे। लंबे पाठ में 90% का लक्ष्य हो तो लगभग 1 अरब पैरामीटर चाहिए होंगे
- सत्यापन में सिर्फ़ यह देखना पर्याप्त नहीं कि उद्धरण सचमुच मौजूद है या नहीं। यह भी जांचना होगा कि उद्धरण में उत्तर की संख्या या नाम है या नहीं, और कर्ता प्रश्न वाले व्यक्ति से वही है या नहीं
- CPU पर चलने वाला 32 करोड़ पैरामीटर का मॉडल, इंटरनेट पर न भेजे जा सकने वाले दस्तावेज़ों के Q&A के लिए बिल्कुल उपयुक्त है। बिना GPU वाले लैपटॉप या सर्वर पर, इसे सिर्फ़ स्थानीय दस्तावेज़ों को आधार बनाकर जवाब देने दिया जा सकता है। गति प्रति प्रश्न कुछ सेकंड से लेकर दसियों सेकंड है, और क्वांटाइज़ेशन से शायद और तेज़ हो जाए (अभी सत्यापित नहीं)
अगली बार 1 अरब पैरामीटर वाले संस्करण के साथ लंबे संदर्भ में 90% का लक्ष्य आज़माना चाहता हूँ।