एक RTX 4090 पर GPT-2 को शून्य से बनाकर देखा: एक दिन में मूल मॉडल से आगे निकला और चैट भी करने लगा
मैंने घर पर मौजूद एक RTX 4090 से GPT-2 (124M) को शून्य से प्रशिक्षित करके देखा। डेटा तैयार करने से लेकर प्री-ट्रेनिंग और उसे चैट करने योग्य बनाने वाली इंस्ट्रक्शन ट्यूनिंग (SFT) तक, सब कुछ अपने ही PC पर किया।
पहले निष्कर्ष:
- प्री-ट्रेनिंग लगभग 21 घंटे में पूरी हुई। सामान्य-ज्ञान तर्क परीक्षण HellaSwag पर 30.5% मिला—मूल GPT-2 124M के 29.4% से अधिक
- SFT में दो घंटे से कम लगे। प्रशिक्षण शुरू होने के सिर्फ 5 मिनट में जवाब बातचीत जैसे होने लगे
- लेकिन अंदर से यह हैलुसिनेशन से भरा है। बेझिझक कह देता है, “पेरिस की आबादी 2.4 अरब है” या “12+7=30”
GPT-2 को धीरे-धीरे समझदार होते देखना दिलचस्प था, इसलिए उस प्रक्रिया को यहाँ संक्षेप में दर्ज कर रहा हूँ।
वातावरण
- GPU: RTX 4090 (24GB)
- CPU: i7-13700K / मेमोरी 64GB
- OS: Windows 11 (WSL का उपयोग नहीं किया; सीधे Windows पर)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
कोड Karpathy के nanoGPT / build-nanogpt जैसी ही पद्धति पर है। मैंने Claude Code से कहा, “इस PC के GPU पर एक दिन में जितना संभव हो, उतना GPT-2 बनाओ,” और कॉन्फ़िगरेशन सुझावों से लेकर स्क्रिप्ट बनाने और प्रशिक्षण की निगरानी तक, सब में साथ लिया।
डेटा की तैयारी: 10B टोकन 12 मिनट में तैयार
प्रशिक्षण डेटा FineWeb-Edu का 10B-टोकन संस्करण था—शिक्षा-केंद्रित, उच्च-गुणवत्ता वाला अंग्रेज़ी वेब टेक्स्ट। parquet में लगभग 27GB।
शुरू में सामान्य Hugging Face डाउनलोड से केवल 1.7MB/s मिल रहा था, इसलिए सब कुछ डाउनलोड करने में चार घंटे से अधिक लगने का अनुमान था। hf_transfer लगाने पर गति 60–70MB/s हो गई और 2GB की फ़ाइल 30 सेकंड में उतरने लगी। फिर बाधा टोकनाइज़ेशन बन गई, और डाउनलोड व टोकनाइज़ेशन मिलाकर लगभग 12 मिनट में सब तैयार हो गया।
वैसे, शुरुआत में मैंने कैश की जगह बदलने वाला HF_HOME, huggingface_hub के import के बाद लिख दिया था। इसलिए सेटिंग लागू नहीं हुई और डाउनलोड दूसरी ड्राइव पर होने लगे। यह पर्यावरण चर import के समय पढ़ा जाता है, इसलिए इसे import से पहले सेट करें। छोटा-सा जाल है।
प्रशिक्षण सेटिंग्स
| आइटम | विवरण |
|---|---|
| मॉडल | GPT-2 small (12 लेयर, 768 डायमेंशन, 124 मिलियन पैरामीटर) |
| 1 स्टेप | लगभग 520,000 टोकन (16×1024 को 32 बार ग्रेडिएंट संचय) |
| स्टेप्स | 16,000 (लगभग 8.4B टोकन) |
| गति | लगभग 120,000 टोकन/सेकंड |
| VRAM | लगभग 12GB |
Windows पर torch.compile नहीं चलता, इसलिए WSL चाहिए—ऐसी बात अक्सर सुनने को मिलती है। लेकिन triton-windows वाले वातावरण में यह सीधे चल गया।
पूरे 10B टोकन चलाने पर 24 घंटे से अधिक लगते, इसलिए एक दिन में समाने के लिए इसे घटाकर 8.4B टोकन किया।
एक छोटा उपाय यह था कि शब्दावली आकार को 50257 से बढ़ाकर 50304 (128 का गुणज) किया। यह Karpathy की प्रसिद्ध तकनीक है, जिससे GPU की मैट्रिक्स गणना तेज़ होती है; और बाद में चैट बनाने में यह अनपेक्षित ढंग से काम आई।
घटना: 2.5 घंटे में प्रशिक्षण रुक गया
बीच की प्रगति देखी तो प्रशिक्षण बंद था। कारण HellaSwag का मूल्यांकन डेटा निकला। nanoGPT-आधारित कोड GitHub के rowanz/hellaswag से डेटा लाता है, लेकिन वह “451 Unavailable For Legal Reasons”—कानूनी कारणों से अनुपलब्ध—हो चुका था। 404 त्रुटि के कारण मूल्यांकन समेत प्रशिक्षण गिर गया।
इसे Hugging Face के Rowan/hellaswag से पढ़ने के लिए बदला—अंदर वही 10,042 प्रश्न हैं—और हर 500 स्टेप पर सहेजे गए चेकपॉइंट से फिर शुरू किया। साथ ही, मूल्यांकन विफल होने पर भी प्रशिक्षण न रुके, इसके लिए उसे try/except में रखा।
लंबे प्रशिक्षण में मूल्यांकन या लॉग जैसी “मुख्य मॉडल से बाहर” की विफलताओं से प्रशिक्षण नहीं गिरना चाहिए। यह ज़रूरी है।
परिणाम: मूल GPT-2 से आगे
वैलिडेशन डेटा का loss कुछ ऐसा रहा। पहले घंटे में तेज़ी से गिरा, फिर धीरे-धीरे कम होता गया।
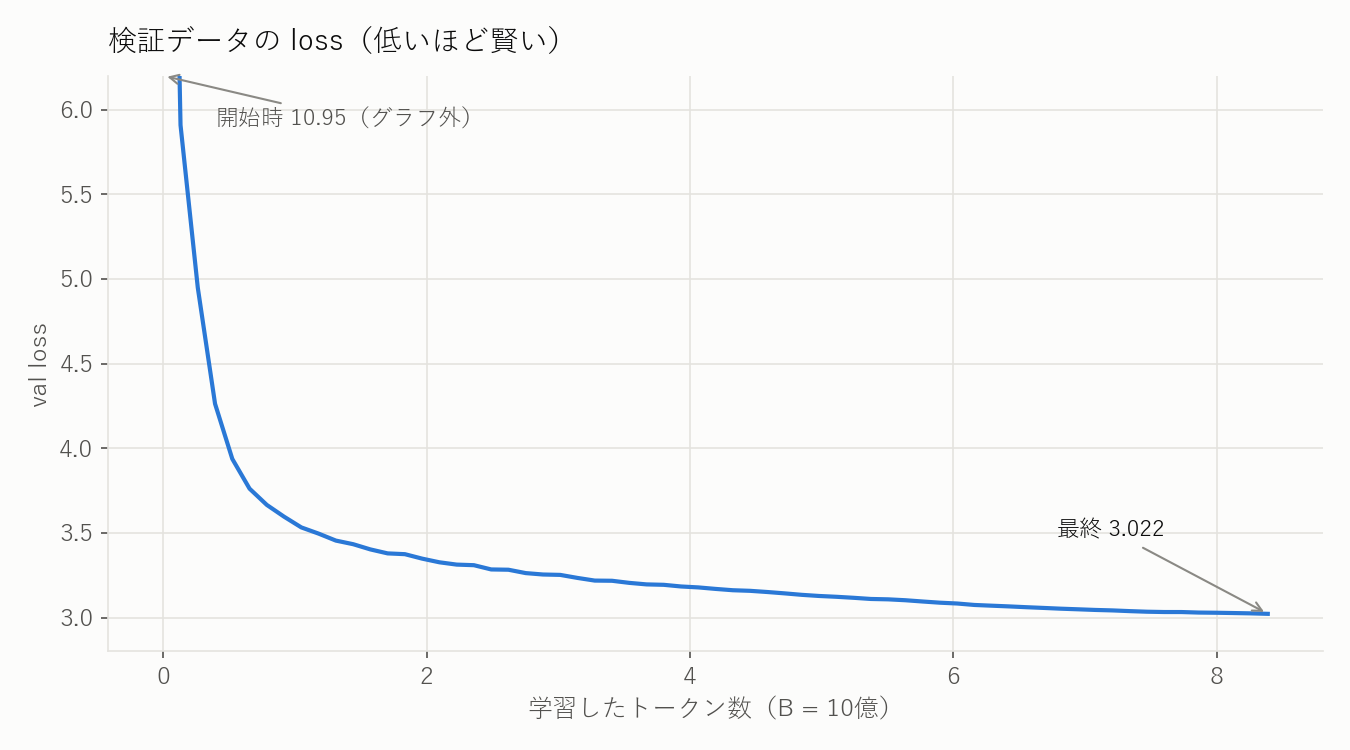
शुरुआत का loss 10.95, ln(50304)≒10.83 के लगभग बराबर है। यानी मॉडल 50,000 शब्दों में से पूरी तरह अंदाज़े से चुनने की स्थिति से शुरू हुआ था।
HellaSwag की सटीकता इस तरह रही।
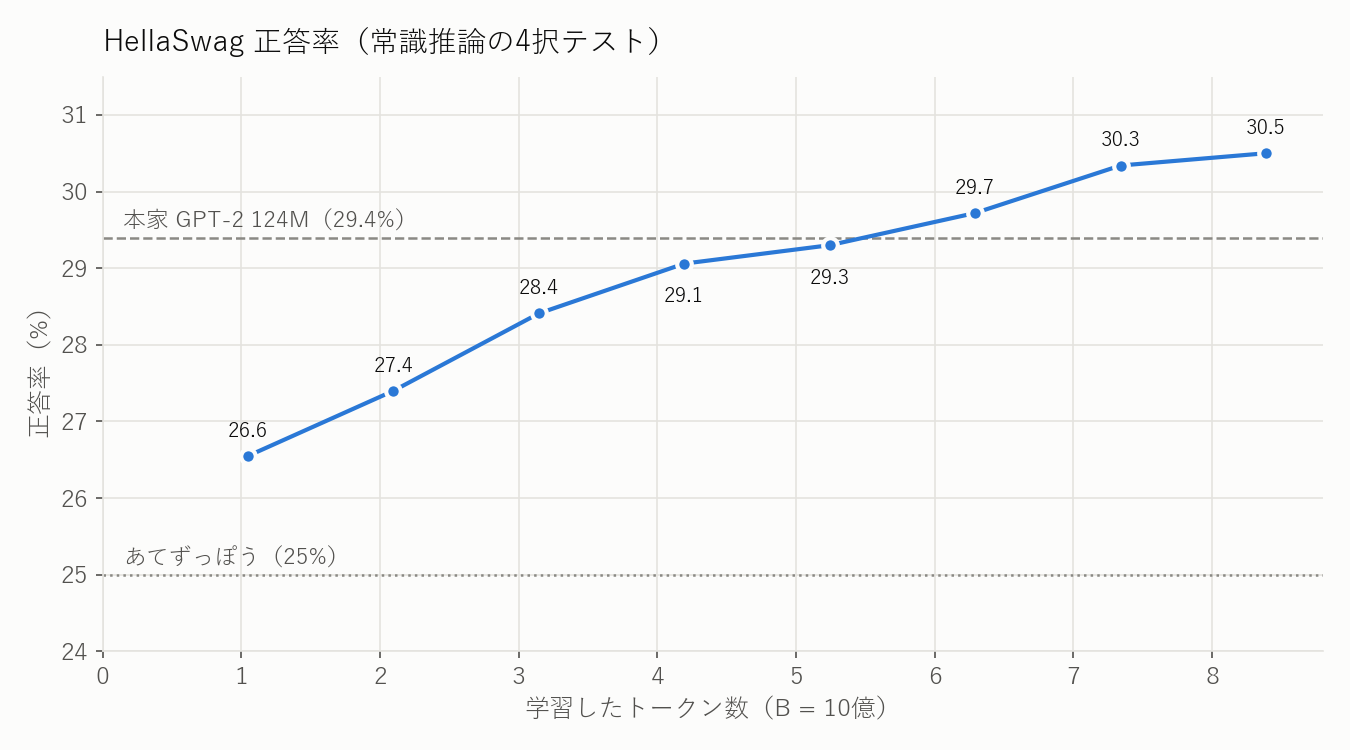
लगभग 6.3B टोकन (step 12,000) पर इसने मूल GPT-2 124M के 29.4% को पार किया, और अंत में 30.5% तक पहुँचा। मूल GPT-2 को WebText पर प्रशिक्षित किया गया था। यहाँ FineWeb-Edu का इस्तेमाल हुआ; मेरा मानना है कि शिक्षा-केंद्रित उच्च-गुणवत्ता डेटा ने फर्क डाला।
धीरे-धीरे समझदार होते हुए
प्रशिक्षण के दौरान हर घंटे एक ही प्रॉम्प्ट से पाठ तैयार कर रिकॉर्ड करता रहा। यही सबसे दिलचस्प हिस्सा था।
प्रशिक्षण से पहले (रैंडम अवस्था)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
शब्द बस पूरी तरह रैंडम क्रम में थे।
37 मिनट बाद (0.26B टोकन)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
वाक्य का रूप बन गया था। इसे समझ आ रहा था कि बात “राजधानी” की है, लेकिन फ्रांस की राजधानी को स्कॉटलैंड की राजधानी बता रहा था।
लगभग 2 घंटे बाद (0.79B टोकन)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
व्याकरण काफी स्वाभाविक हो गया था। बदले में, इसने तकनीकी शब्दों को जोड़कर विश्वसनीय लगने वाले झूठ बोलना शुरू कर दिया। हैलुसिनेशन का शुरुआती रूप जैसा लगा।
लगभग 2.1B टोकन
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
आखिरकार इसने Paris कह दिया! …लेकिन उसके तुरंत बाद झूठा आँकड़ा जोड़ दिया कि “फ्रांस दुनिया के 50% इस्पात का उत्पादन करता है।”
तैयार बेस मॉडल से प्रश्न पूछे
Question: ... Answer: के रूप में 10 प्रश्न पूछे।
- What is the capital of France? → (a) से (i) तक विकल्प लिखकर प्रश्न-पत्र बनाने लगा
- Who was Albert Einstein? → “16 नवंबर 1918 को सेंट लुइस, मिसौरी में जन्मे। पिता खनिक थे और स्वयं स्कूल शिक्षक थे।” सब झूठ है, लेकिन जीवनी जैसा लिख सकता है
- What is 12 plus 7? → “12 plus 7 is an arithmetic expression.” गणना करने के बजाय परिभाषा बताने लगा
इसके पास कुछ ज्ञान है, मगर यह “प्रश्न का उत्तर देना” वाला व्यवहार नहीं जानता। बेस मॉडल तो मूलतः “पाठ का अगला हिस्सा लिखने” की मशीन है, इसलिए यह स्वाभाविक है।
SFT से इसे चैट करने योग्य बनाया
अब इसे ChatGPT की तरह प्रश्नों का उत्तर देने योग्य बनाने के लिए इंस्ट्रक्शन ट्यूनिंग (SFT) की।
- डेटा: Hugging Face का
smol-smoltalk(लगभग 460,000 वार्तालाप, 270 मिलियन टोकन) - चैट प्रारूप:
<|user|><|assistant|><|end|>जैसे विभाजक चिह्न जोड़े। यहाँ पहले शब्दावली को 50304 तक बढ़ाने से बनी खाली IDs को फिर इस्तेमाल किया। मॉडल की संरचना बदले बिना विशेष टोकन जोड़ सके, इसलिए गति के लिए किया गया छोटा उपाय यहाँ काम आया - केवल उत्तर वाले हिस्से पर प्रशिक्षण: प्रश्न को केवल पढ़ता है; अनुकरण केवल सहायक के उत्तर और अंत के
<|end|>का कराया गया - 2 epochs, लगभग 1 घंटा 50 मिनट
मुख्य बात है <|end|> तक प्रशिक्षण देना। इससे मॉडल बात पूरी होने पर खुद रुकना सीखता है। ChatGPT आदि में भी यही तंत्र है: अंत का चिह्न आने पर जनरेशन रोक दी जाती है।
सिर्फ़ 5 मिनट में बातचीत जैसा
SFT शुरू होने से पहले (step 0), अपरिचित विभाजक चिह्नों से भ्रमित होकर यह “jakjakjakjak…” की अनंत लूप में चला जाता था। लेकिन 500 स्टेप (लगभग 5 मिनट) में ही यह बातचीत जैसा हो गया।
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
और यह बात पूरी कर सचमुच रुक भी जाता है। बोलने का ढंग सीखना बहुत तेज़ था।
हालाँकि ज्ञान पहले जैसा ही रहा। बीच के एक मॉडल ने कहा कि “पेरिस दुनिया का सबसे बड़ा शहर है और इसकी आबादी लगभग 2.4 अरब है।”
SFT से पहले और बाद की तुलना
एक ही प्रश्नों पर SFT से पहले (बेस मॉडल) और बाद के परिणामों की तुलना की।
| प्रश्न | SFT से पहले | SFT के बाद |
|---|---|---|
| What is the capital of France? | (a) से (i) तक विकल्प लिखने लगता है | “The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.” |
| Who are you? | “I am the person who has the gift for all that I do.” | “I'm a language learning AI assistant with over 10 years of experience” (AI होते हुए भी 10 साल का अनुभव) |
| Translate "Good morning" into French. | प्रश्न से असंबंधित बात करने लगता है | “Bonjour!” (सही उत्तर, लेकिन फिर “Good morning (modifier)” को लगातार दोहराता है) |
| What is 12 plus 7? | “arithmetic expression है” | “12 + 7 = 21” → “12 + 7 = 30” → “35 + 7 = 34”—विश्वसनीय दिखने वाले तरीके से लगातार गलत होता जाता है |
| Who was Albert Einstein? | पिता खनिक थे, स्वयं स्कूल शिक्षक | “prominent physicist” का मोटा विवरण सही है। लेकिन “24 फ़रवरी 1905 को वियना में जन्मे” झूठ है |
लहजा और प्रारूप पूरी तरह सहायक जैसे हैं; सामग्री में बहुत झूठ है। गणित की स्थिति बेहद खराब थी।
वास्तव में चैट करके देखा
टर्मिनल में बातचीत करने वाला chat.py बनाया और उससे बात की।
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
यह “एक वाक्य में” वाली हिदायत मान रहा है। बेस मॉडल यह नहीं कर सकता था।
एक दूसरी बातचीत में राजधानी पूछने के बाद उसकी आबादी पूछी।
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
यह पिछली बातचीत के आधार पर “there = जापान” समझता है। लेकिन पहले 50,000 की आबादी कहता है और तुरंत बाद उत्तर में कहता है कि उत्तरी हिस्से में 1.5 अरब लोग रहते हैं—पूरी तरह बेतुका।
जापानी में “जापान की राजधानी क्या है?” पूछा तो इसने ऐसा जवाब दिया।
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
क्योंकि इसे केवल अंग्रेज़ी डेटा पर प्रशिक्षित किया गया था, जापानी इसे शायद “ऐसा अज्ञात पाठ जिसे सुधारवाना है” जैसा लगा।
अंत में मैंने कहा, “GPU पर एक हाइकू लिखो,” तो इसने “I see the world, the thoughts, the emotions” को लगातार दोहराने वाली कविता बना दी। हाइकू कहाँ गया?
इसे करके क्या समझ आया
- एक RTX 4090 और एक दिन में ऐसा मॉडल बनाया जा सकता है जो मूल GPT-2 से आगे निकल जाए। GPU की बिजली खपत लगभग 430W रही। केवल GPU का बिजली खर्च मोटे तौर पर 300 येन (अनुमानित) था
- बोलने का ढंग एक क्षण में सीखा जा सकता है, लेकिन ज्ञान प्री-ट्रेनिंग से तय होता है। SFT से 5 मिनट में बातचीत का प्रारूप आ गया, लेकिन तथ्यों की सटीकता लगभग नहीं बदली
- 124M मॉडल का व्याकरण लगभग पूर्ण है, लेकिन सामग्री झूठ से भरी है। प्रवाह और सही होने में अंतर है—यह बात प्रत्यक्ष रूप से समझ आती है
- लंबा प्रशिक्षण इन्फ्रास्ट्रक्चर वाली समस्याओं से गिरता है। इस बार मॉडल नहीं, बल्कि मूल्यांकन डेटा की जगह गायब होने से प्रशिक्षण रुका
खुद शून्य से बनाने पर अनुभव से समझ आता है कि ChatGPT जैसा AI, “अगला पाठ अनुमान करने वाली मशीन” को “बातचीत का शिष्टाचार” सिखाने का परिणाम है। अगली बार ऐसा मॉडल बनाना चाहूँगा जो कुछ अधिक व्यावहारिक हो।