3,200万パラメータでクロアチア語TTSモデルを作ってみた。学習途中の声を聞き比べ
क्रोएशियाई RAG के लिए LLM के बाद, इस बार मैंने सिर्फ़ क्रोएशियाई के लिए एक छोटा टेक्स्ट-टू-स्पीच (TTS) मॉडल बनाया। लक्ष्य था कि यह स्मार्टफ़ोन के CPU पर रीयल टाइम में चले।
तरीका था “डिस्टिलेशन।” मैंने एक बड़े स्पीच-सिंथेसिस मॉडल (HiggsAudio v3) से क्रोएशियाई स्क्रिप्ट पढ़वाकर प्रशिक्षण डेटा बनाया और उससे एक छोटा मॉडल शून्य से प्रशिक्षित किया। इस बार पहले 7.5 घंटे के डेटा से पायलट प्रशिक्षण किया और सुना कि एक ही वाक्य प्रशिक्षण के साथ कैसे बदलता है।
पहले निष्कर्ष।
- 3.2 करोड़ पैरामीटर (Matcha-TTS 1.83 करोड़ + Vocos 1.35 करोड़) के साथ मॉडल ने ठीक से क्रोएशियाई बोली
- 50 मिनट के प्रशिक्षण (5,000 स्टेप) पर ही यह स्क्रिप्ट के अनुसार पढ़ने लगा था। उसके बाद मुख्यतः “शोर” में सुधार हुआ
- मूल्यांकन के 14 वाक्यों में अंतिम अक्षर-त्रुटि दर 0.9% रही (14 में से 10 वाक्य पूरी तरह सटीक)
- CPU के एक ही थ्रेड पर भी, यह 1 सेकंड का ऑडियो 0.09 सेकंड में बना सका (i7-13700K)
डेमो: इसे बोलते हुए आज़माएँ
मैंने इस लेख का मॉडल (अंतिम 30,000-स्टेप संस्करण) क्रोएशियाई TTS प्लेग्राउंड पर रखा है। अपनी पसंद का क्रोएशियाई पाठ डालें और वह तुरंत उसे पढ़कर सुनाएगा।
- 50 उदाहरण वाक्यों (अभिवादन, यात्रा, अस्पताल आदि) में से चुनें, या स्वयं अधिकतम 1,000 अक्षर दर्ज करें
- बोलने की गति, उतार-चढ़ाव की मात्रा और सिंथेसिस स्टेप की संख्या बदली जा सकती है। सीड को स्थिर रखने पर एक ही वाक्य हर बार एक ही ऑडियो देगा
- सिंथेसिस केवल सर्वर के CPU पर चलता है (ONNX Runtime, GPU या बाहरी API का उपयोग नहीं)
- यह संख्याएँ नहीं पढ़ सकता, इसलिए उन्हें
dvadeset pet(25)जैसे शब्दों में लिखना होगा
मैंने क्या किया
1. स्क्रिप्ट बनाना: स्थानीय Gemma 4 31B से क्रोएशियाई रोज़मर्रा की बातचीत के संवाद लिखवाए। “बाज़ार में दादी से बात कर रही है” या “आधी रात को अजीब आवाज़ सुनकर डर गई” जैसी स्थितियाँ, सामने वाला व्यक्ति, भावना और लंबाई को यादृच्छिक रूप से तय किया, और हर बार 22 पंक्तियाँ बनवाईं। वक्ता 30 वर्ष की एक महिला मानी गई। 23 तरह की भावनाएँ (सामान्य, खुशी, गुस्सा, फुसफुसाहट आदि) मिलाई गईं।
2. उन्हें ऑडियो में बदलना: HiggsAudio v3 से संदर्भ ऑडियो (16 सेकंड) की आवाज़ में स्क्रिप्ट पढ़वाई। भावनात्मक टैग (<|emotion:anger|> आदि) जोड़ने पर यह सचमुच गुस्से या खुशी के साथ बोलता है। लगभग 5 घंटे में 4,500 क्लिप बनाए।
3. अपने-आप जाँच करना: Whisper large-v3 से ट्रांसक्राइब कराकर उसे स्क्रिप्ट से मिलाया और गलत पढ़े गए क्लिप हटाए। साथ ही, स्पीकर-रिकग्निशन मॉडल से संदर्भ ऑडियो के साथ आवाज़ की समानता मापी और जिनकी आवाज़ बदल गई थी उन्हें भी हटाया। पास हुए 4,500 में से 4,393 क्लिप (97.6%)। आगे-पीछे का मौन हटाने पर कुल 7.46 घंटे बचे।
4. छोटे मॉडल को प्रशिक्षित करना: Matcha-TTS (फ्लो-मैचिंग विधि वाला TTS) को RTX 4090 पर 5 घंटे प्रशिक्षित किया। लगभग 30,000 स्टेप। ऑडियो वेवफ़ॉर्म में वापस बदलने वाले भाग (वोकोडर) के लिए सार्वजनिक Vocos को ज्यों का त्यों इस्तेमाल किया।
क्रोएशियाई में लगभग जैसा लिखा जाता है वैसा ही पढ़ा जाता है, इसलिए उसे ध्वन्यात्मक चिह्नों में नहीं बदला और अक्षरों को सीधे इनपुट बनाया। हालाँकि lj, nj और dž एक-एक ध्वनि हैं, इसलिए उन्हें एक अक्षर की तरह जोड़ा।
प्रशिक्षण के दौरान की आवाज़ों की तुलना
प्रशिक्षण डेटा में शामिल न किए गए वाक्य “Molim Vas, možete li mi reći koliko košta ova haljina?(माफ़ कीजिए, इस ड्रेस की कीमत कितनी है?)” को प्रशिक्षण के अलग-अलग चरणों के मॉडल से सिंथेसाइज़ किया।
स्टेप 5,000(प्रशिक्षण शुरू होने के लगभग 50 मिनट बाद)
स्टेप 10,000(लगभग 1 घंटा 40 मिनट)
स्टेप 15,000(लगभग 2 घंटे 20 मिनट)
स्टेप 20,000(लगभग 3 घंटे 10 मिनट)
स्टेप 30,000(लगभग 5 घंटे, अंतिम)
तुलना के लिए, शिक्षक की भूमिका वाले HiggsAudio द्वारा बनाया गया प्रशिक्षण डेटा का एक क्लिप (अलग वाक्य: “Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.”)।
Whisper से ट्रांसक्राइब करने पर यह वाक्य स्टेप 5,000 से लेकर अंत तक, हर बार स्क्रिप्ट से अक्षरशः समान था। यानी “क्या कहा जा रहा है” वाला हिस्सा शुरू से ही ठीक था।
अंतर आवाज़ की सफ़ाई में था। सुनने पर लगा कि स्टेप 5,000 में किरकिरा शोर था, जो स्टेप 10,000 पर काफी कम हो गया। उसी ऑडियो को स्पेक्ट्रोग्राम (क्षैतिज अक्ष समय, ऊर्ध्वाधर अक्ष आवृत्ति) में देखने पर यह साफ़ दिखता है।
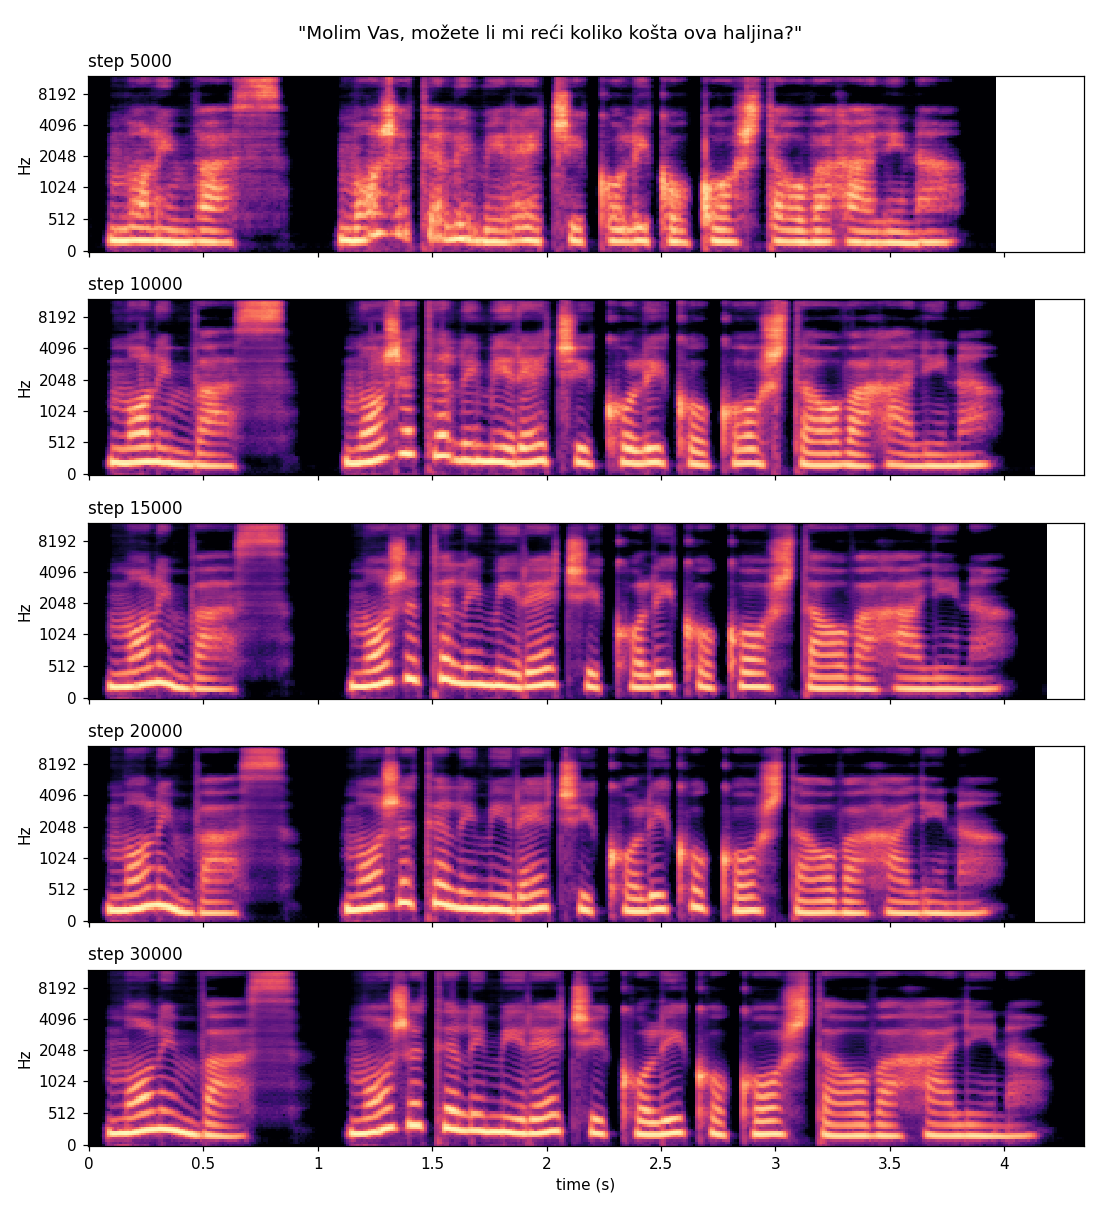
आवाज़ की पिच के अनुरूप दिखाई देने वाली क्षैतिज धारियाँ (हार्मोनिक्स) स्टेप 5,000 पर धुंधली हैं और उनके बीच की जगह हल्की-सी भर गई है। यही हिस्सा शोर जैसा सुनाई देता है। स्टेप 10,000 के बाद धारियाँ स्पष्ट हो जाती हैं और उनके बीच की जगह गहरी दिखती है। प्रशिक्षण बढ़ने के साथ धारियाँ ऊपर-नीचे अधिक सहज वक्र बनाने लगती हैं, जिससे लगता है कि पिच की गति (इंटोनेशन) भी अधिक स्पष्ट हो गई है।
आँकड़ों में देखें
मूल्यांकन के 14 वाक्यों (सभी प्रशिक्षण डेटा से बाहर) को Whisper large-v3 से ट्रांसक्राइब कराकर अक्षर-त्रुटि दर (CER) मापी। इनमें छोटे अभिवादन से लेकर लगभग 16 सेकंड के एकालाप तक शामिल हैं।
| स्टेप | प्रशिक्षण समय | अक्षर-त्रुटि दर | पूर्ण मिलान |
|---|---|---|---|
| 5,000 | लगभग 50 मिनट | 1.1% | 9 / 14 |
| 10,000 | लगभग 1 घंटा 40 मिनट | 3.4% | 8 / 14 |
| 15,000 | लगभग 2 घंटे 20 मिनट | 0.7% | 11 / 14 |
| 20,000 | लगभग 3 घंटे 10 मिनट | 0.9% | 11 / 14 |
| 30,000 | लगभग 5 घंटे | 0.9% | 10 / 14 |
- स्टेप 10,000 पर आँकड़ा खराब होने का कारण लगभग पूरी तरह एक वाक्य “Bok!(हाय!)” का “Vok” सुना जाना था। तीन में एक अक्षर अलग होने से, इसी एक वाक्य की त्रुटि दर 33% हो जाती है। कान से सुनने पर स्टेप 10,000, स्टेप 5,000 से कहीं साफ़ था। अक्षर-त्रुटि दर केवल यह मापती है कि पाठ पढ़ा गया या नहीं; आवाज़ की सफ़ाई का आकलन सुनकर ही करना पड़ता है
- अंत तक बची गलतियाँ “Đak je pojeo džem(छात्र ने जैम खाया)” में đ और dž थीं। ये क्रोएशियाई में भी कम आने वाली ध्वनियाँ हैं, जिन्हें “Žak” और “Džak” सुना गया
CPU पर गति
i7-13700K पर PyTorch के मूल रूप में (बिना ऑप्टिमाइज़ेशन) मापा। 4 वाक्यों, कुल 47.6 सेकंड के ऑडियो को 3 बार बनाने का औसत लिया। RTF का अर्थ है “बनाने में लगा समय ÷ ऑडियो की अवधि”; जितना छोटा, उतना तेज़।
| थ्रेड की संख्या | स्टेप की संख्या | Matcha | Vocos | कुल RTF |
|---|---|---|---|---|
| 1 | 2 | 0.042 | 0.025 | 0.067 |
| 1 | 4 | 0.067 | 0.025 | 0.092 |
| 4 | 4 | 0.032 | 0.010 | 0.042 |
| 8 | 4 | 0.028 | 0.007 | 0.036 |
“स्टेप की संख्या” सिंथेसिस के दौरान शोर से ऑडियो बनाने की पुनरावृत्तियों की संख्या है; ऊपर की सुनने वाली तुलना 4 स्टेप से बनाई गई थी। एक थ्रेड पर भी 1 सेकंड का ऑडियो 0.09 सेकंड में बन सकता है। स्मार्टफ़ोन का CPU इससे धीमा है, लेकिन यह रीयल टाइम में चलने लायक होना चाहिए (अभी वास्तविक डिवाइस पर नहीं मापा है, इसलिए यह अनुमान है)।
TTS के लिए कितने घंटे का डेटा चाहिए?
7.5 घंटे में इतना संभव हुआ, इसलिए सामान्य मानक देखे।
- एक आवाज़ वाले TTS के लिए अक्सर इस्तेमाल होने वाले अंग्रेज़ी LJSpeech में लगभग 24 घंटे का डेटा है। Matcha-TTS का आधिकारिक मॉडल भी इसी पर प्रशिक्षित है
- जापानी JSUT और चीनी CSMSC में लगभग 10 घंटे का डेटा है और इन्हें एक आवाज़ के कॉर्पस के रूप में सामान्य रूप से प्रयोग किया जाता है
- शून्य से प्रशिक्षण के लिए लगभग 1 घंटा निचली सीमा है; मॉडल के अनुसार उच्चारण की गलतियाँ बढ़ सकती हैं
- पहले से प्रशिक्षित मॉडल को आगे प्रशिक्षित करने पर, 30 मिनट का डेटा शून्य से 27 घंटे प्रशिक्षण देने के बराबर हो गया—ऐसी रिपोर्ट भी है
केवल सिंथेटिक आवाज़ से Matcha-TTS प्रशिक्षित करने पर शोध (शंघाई जियाओ टोंग विश्वविद्यालय, दिसंबर 2025) भी मिला। उसके अनुसार, पाठ के प्रकार जितने अधिक हों, ऑडियो जितना स्वच्छ और शोर-मुक्त हो, और बोलने का ढंग जितना एकरूप हो, प्रशिक्षण उतना आसान होता है। सिंथेटिक डेटा में शोर नहीं होता और बोलने का ढंग भी एकसमान होता है, इसलिए एक ही अवधि में यह वास्तविक रिकॉर्डिंग से सीखने में आसान हो सकता है। शायद इसी वजह से इस बार 7.5 घंटे में यहाँ तक पहुँचना संभव हुआ।
जिन मुश्किलों में फँसा
- PC जम गया: स्क्रिप्ट बनाने वाला 31B मॉडल गलती से एक साथ दो बार GPU में लोड हो गया और VRAM भर गई। तब से नियम है कि “GPU पर हमेशा केवल एक मॉडल लोड होगा”
- Gemma 4 का ज़रूरत से ज़्यादा सोचना: आउटपुट का लगभग दो-तिहाई हिस्सा “सोच” था। सोचने की सुविधा बंद करने पर यह लगभग 3 गुना तेज़ हो गया
- HiggsAudio का मतिभ्रम: शुरुआती परीक्षण में इसने वाक्य के बाद के मौन में अपनी ओर से “Hvala što pratite kanal(चैनल देखने के लिए धन्यवाद)” जोड़ दिया और 81 सेकंड का क्लिप बन गया। लगता है इसे YouTube के समापन वाक्य याद हैं। जिन क्लिप की लंबाई अनुमान से बहुत अलग थी, उन्हें हटाने लगा
- Windows पर Matcha-TTS नहीं चला: कुछ C एक्सटेंशन बन नहीं पाए, इसलिए उस हिस्से को Python (numba) में फिर से लिखा